Comparando la abundancia de las especies: GLM para conteos
Qué hacer cuando la variable respuesta es un conteo
Este es el cuarto y último post de la serie basada en el curso R aplicado a Ecología: de individuos a comunidades. En el primero ajustamos un modelo lineal a la riqueza de especies de las playas de RIKZ y vimos que no cumplía los supuestos. Quedó pendiente una alternativa mejor, y de eso se trata este post.
Datos de conteo
Muchas variables en ecología son conteos: la cantidad de individuos en una parcela, la cantidad de especies en un sitio, la cantidad de visitas de polinizadores a una flor en una hora. Tienen dos particularidades: solo toman valores enteros y nunca son negativos.
Como vimos en el post del GLM binomial, los modelos lineales generalizados admiten distintas distribuciones para la variable respuesta. Para conteos en un período de tiempo o un espacio determinados, la opción natural es la distribución de Poisson.
El GLM Poisson
Repasemos las tres partes de un GLM para este caso.
Componente aleatoria. Y sigue una distribución de Poisson con media μ:
P(Y = y) = μʸ · exp(−μ) / y!
Esta distribución tiene una propiedad muy particular: la media y la varianza son iguales, E(Y) = Var(Y) = μ. Es una restricción fuerte, y enseguida vamos a ver por qué importa.
Función de enlace y componente sistemática. La función de enlace es el logaritmo:
log(μ) = β₀ + β₁x
Por lo tanto:
μ = exp(β₀ + β₁x) = exp(β₀) × exp(β₁)ˣ
Esto tiene dos consecuencias. La primera es que μ siempre es positiva, como corresponde a un conteo. La segunda es que el efecto de x es multiplicativo: cada vez que x aumenta una unidad, la media se multiplica por exp(β₁).
Ejemplo: la riqueza en RIKZ
Volvemos al modelo del primer post:
regsimple <- lm(Richness ~ NAP, data = rikz)
Cuando miramos los residuos vimos que no cumplía los supuestos. Y tiene sentido: la riqueza no es otra cosa que la cantidad de especies por sitio, es decir, un conteo. Lo podemos modelar con un GLM Poisson:
regpoisson <- glm(Richness ~ NAP, family = "poisson", data = rikz)
> summary(regpoisson)

Coefficients:
            Estimate Std. Error z value Pr(>|z|)
(Intercept)  1.79100    0.06329  28.297  < 2e-16 ***
NAP         -0.55597    0.07163  -7.762 8.39e-15 ***
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

(Dispersion parameter for poisson family taken to be 1)

    Null deviance: 179.75  on 44  degrees of freedom
Residual deviance: 113.18  on 43  degrees of freedom
AIC: 259.18
Interpretar los coeficientes
Los coeficientes están en la escala de la función de enlace, en este caso el logaritmo. Para volver a la escala de los datos tenemos que antitransformarlos con la función inversa, la exponencial:
- Intercepto: exp(1.791) ≈ 6.0. Es la riqueza media esperada cuando NAP = 0.
- Pendiente: exp(−0.556) ≈ 0.57. Por cada unidad que aumenta NAP, la riqueza esperada se multiplica por 0.57, es decir que cae un 43%.
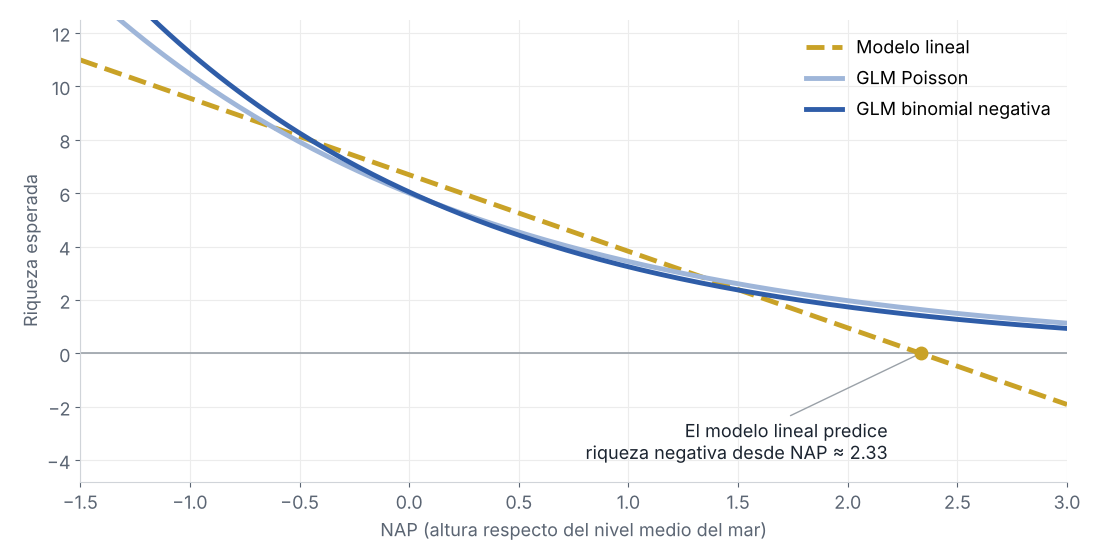
Comparemos con el modelo lineal, que decía que por cada metro de altura se pierden 2.87 especies. Esa pérdida es la misma en todos los sitios, así que para NAP mayores a 2.33 la recta predice una riqueza negativa, algo imposible. En el GLM Poisson, en cambio, la pérdida es proporcional: se pierden más especies donde hay muchas y menos donde hay pocas, y la riqueza nunca llega a cero.
Chequear el ajuste
Para chequear el ajuste del modelo podemos comparar la deviance residual con una distribución chi-cuadrado:
> pchisq(deviance(regpoisson), df.residual(regpoisson), lower.tail = FALSE)
[1] 3.151767e-08
El p-valor es muy chico, así que el GLM Poisson no ajusta bien. ¿Por qué? Porque los datos tienen sobredispersión.
Sobredispersión
Dijimos que la distribución de Poisson tiene una restricción fuerte: la varianza tiene que ser igual a la media. Cuando la varianza es mayor que la media, Var(Y) > E(Y), decimos que hay sobredispersión. Es algo muy frecuente en datos biológicos: los individuos suelen agruparse, los sitios difieren en cosas que no medimos, y todo eso agrega variabilidad.
Una forma rápida de detectarla es dividir la deviance residual por sus grados de libertad. Si no hay sobredispersión, ese cociente debería estar cerca de 1:
> deviance(regpoisson) / df.residual(regpoisson)
[1] 2.63
En nuestro caso la variabilidad es más de dos veces y media la que admite el modelo. Si ignoramos la sobredispersión, los errores estándar quedan subestimados y los p-valores salen más chicos de lo que deberían: vamos a encontrar efectos “significativos” que no lo son.
Las principales alternativas para modelar datos con sobredispersión son:
- GLM quasipoisson: introduce en el cálculo de la verosimilitud un parámetro de dispersión (φ). Lo que se obtiene es una “cuasiverosimilitud”, que no se puede usar para calcular otros valores como el AIC.
- GLM binomial negativa: usa una distribución que admite más dispersión que la de Poisson. Es la que vamos a ver.
El GLM binomial negativa
En la distribución binomial negativa la varianza ya no es igual a la media, sino que tiene un término extra:
Var(Y) = μ + μ² / θ
El parámetro θ controla cuánta variabilidad extra hay: cuanto más chico, más sobredispersión. Si θ es muy grande, el segundo término desaparece y volvemos a Poisson.
En R lo ajustamos con la función glm.nb() del paquete MASS:
library(MASS)
regbn <- glm.nb(Richness ~ NAP, data = rikz)
> summary(regbn)

Coefficients:
            Estimate Std. Error z value Pr(>|z|)
(Intercept)   1.7985     0.1037  17.336  < 2e-16 ***
NAP          -0.6230     0.1122  -5.552 2.83e-08 ***
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

(Dispersion parameter for Negative Binomial(3.7122) family taken to be 1)

    Null deviance: 76.231  on 44  degrees of freedom
Residual deviance: 46.275  on 43  degrees of freedom
AIC: 231.75
Los coeficientes se interpretan igual que en Poisson, porque la función de enlace también es el logaritmo: la riqueza esperada en NAP = 0 es exp(1.7985) ≈ 6.0, y se multiplica por exp(−0.623) ≈ 0.54 por cada unidad que aumenta NAP. El θ estimado es 3.71.
Fijate que las estimaciones son muy parecidas a las del modelo Poisson, pero los errores estándar son bastante más grandes (0.11 contra 0.07 para NAP). Esa es justamente la incertidumbre que el modelo Poisson estaba ignorando. En este caso el efecto de NAP es tan fuerte que sigue siendo significativo, pero con efectos más débiles la diferencia puede cambiar las conclusiones.
Chequeamos el ajuste igual que antes:
> deviance(regbn) / df.residual(regbn)
[1] 1.07

> pchisq(deviance(regbn), df.residual(regbn), lower.tail = FALSE)
[1] 0.339
El cociente está cerca de 1 y el test no muestra falta de ajuste: el GLM binomial negativa ajusta bien los datos. El AIC también lo prefiere: 231.75 contra 259.18 del Poisson.
Cuando el esfuerzo de muestreo no es el mismo
Al principio dijimos que el GLM Poisson modela conteos en un período de tiempo o un espacio determinados. ¿Qué pasa cuando no todas las observaciones tienen el mismo esfuerzo? Por ejemplo, si contamos arañas en cuadrículas de distinto tamaño, o aves durante 10 minutos en unos sitios y 20 en otros.
Una primera idea es dividir cada conteo por el tamaño de la cuadrícula, para llevar todos los datos a su equivalente en 1 m²:
| Arañas | Tamaño de la cuadrícula (m²) | Arañas por m² |
|---|---|---|
| 4 | 1 | 4 |
| 7 | 1.5 | 4.67 |
| 9 | 2 | 4.5 |
El problema es que los datos ya no son conteos: dejan de ser enteros y ya no siguen una distribución de Poisson ni binomial negativa.
Una mejor idea es seguir usando un GLM para conteos, pero agregando un offset. Lo que queremos modelar es la densidad, es decir, la media dividida por el tamaño de la cuadrícula:
log(μ / tamaño) = β₀ + β₁x
Que es equivalente a:
log(μ) = β₀ + β₁x + log(tamaño)
El término log(tamaño) es el offset: una variable que entra al modelo con un coeficiente fijo igual a 1, sin que haya que estimarlo. Así podemos “estandarizar” los datos sin hacerles ninguna operación.
En R, con un GLM Poisson:
glm(aranas ~ tipo_terreno + pres_insectos,
    offset = log(tam.cuadricula),
    family = "poisson",
    data = datos)
Y con una binomial negativa, el offset va dentro de la fórmula:
glm.nb(aranas ~ tipo_terreno + pres_insectos + offset(log(tam.cuadricula)),
       data = datos)
Para cerrar la serie
A lo largo de estos cuatro posts recorrimos el camino que sigue cualquier análisis de datos ecológicos. Empezamos por el modelo lineal y vimos sus límites. Para datos de presencia y ausencia pasamos al GLM binomial, y con los modelos de ocupación tuvimos en cuenta que no siempre detectamos lo que está. Por último, para los conteos usamos los GLM Poisson y binomial negativa.
La idea de fondo es siempre la misma: elegir un modelo que respete cómo se generaron los datos, en vez de forzar los datos para que entren en el modelo.