El modelo lineal en ecología, de la salida al paper
Cómo ajustar, leer, chequear y reportar un modelo lineal
Hace unos años, junto a Nicolás Pelegrin, dimos un curso de posgrado en el Doctorado en Ciencias Biológicas de la UNC que titulamos R aplicado a Ecología: de individuos a comunidades. Ahora voy a adaptar esas clases en una serie de posts disponibles para todo el mundo, empezando por este donde vamos a ver la aplicación práctica de modelos lineales en datos ecológicos.
En un post anterior conté que la regresión, el ANOVA y el test t son en realidad el mismo modelo lineal. Si no lo leíste, te recomiendo empezar por ahí. Hoy vamos a lo práctico: cómo se ajusta un modelo lineal en R, cómo se lee la salida, cómo se chequean los supuestos y qué hay que poner en el paper.
El ejemplo: las playas de RIKZ
Vamos a usar un dataset clásico de los libros de Zuur y colaboradores: RIKZ. Tiene la abundancia de 75 especies de invertebrados medida en 45 sitios de playas de Holanda, junto con variables abióticas como la composición del sedimento o la pendiente de la playa.
Este es un caso típico de dataset multivariado pero en este caso vamos a utilizarlo para un análisis univariado. Por eso vamos a resumir la comunidad de cada sitio en un solo número, la riqueza (cantidad de especies), y buscaremos evaluar si es explicada por la altura del sitio respecto del nivel medio del mar (NAP).
Ajustar el modelo
Como vimos en el post anterior, un modelo lineal se especifica en R de la siguiente manera:
regsimple <- lm(Richness ~ NAP, data = rikz)
A la izquierda de la ~ va la variable respuesta, a la derecha la explicativa, y en data la tabla. Si la variable explicativa es continua estamos haciendo una regresión; si es un factor, un ANOVA. La función es la misma.
Leer la salida
> summary(regsimple)
Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)   6.6857     0.6578  10.164 5.25e-13 ***
NAP          -2.8669     0.6307  -4.545 4.42e-05 ***

Residual standard error: 4.16 on 43 degrees of freedom
Multiple R-squared:  0.3245,	Adjusted R-squared:  0.3088
F-statistic: 20.66 on 1 and 43 DF,  p-value: 4.418e-05
Lo primero que miramos son los coeficientes:
- Intercepto (6.69): la riqueza promedio esperada cuando NAP = 0, es decir, en un sitio que está justo al nivel medio del mar.
- Pendiente (−2.87): cuánto cambia la riqueza por cada unidad que aumenta NAP. En este caso, por cada metro más de altura se pierden casi tres especies.
Con eso ya podemos escribir la recta del modelo:
Riqueza = 6.69 − 2.87 × NAP
La columna Pr(>|t|) es el test de cada coeficiente. Para la pendiente, la hipótesis nula es que vale cero (no hay relación lineal entre X e Y). Con un p de 4.4 × 10⁻⁵ tenemos evidencia de que la riqueza sí depende de NAP. El R² nos dice que NAP explica alrededor del 32% de la variabilidad en la riqueza.
Chequear los supuestos
El modelo lineal asume cuatro cosas sobre los errores (lo que el modelo no explica):
- Media cero.
- Varianza constante (homocedasticidad): la dispersión de los residuos no debería cambiar a lo largo de los valores ajustados.
- Distribución normal.
- Independencia: depende sobre todo de que el diseño del muestreo esté bien hecho. Cuando no se cumple, hay modelos que permiten tenerlo en cuenta, como los mixtos y los marginales.
En R, la forma más rápida de mirar los tres primeros es graficar el modelo:
par(mfrow = c(2, 2))
plot(regsimple)
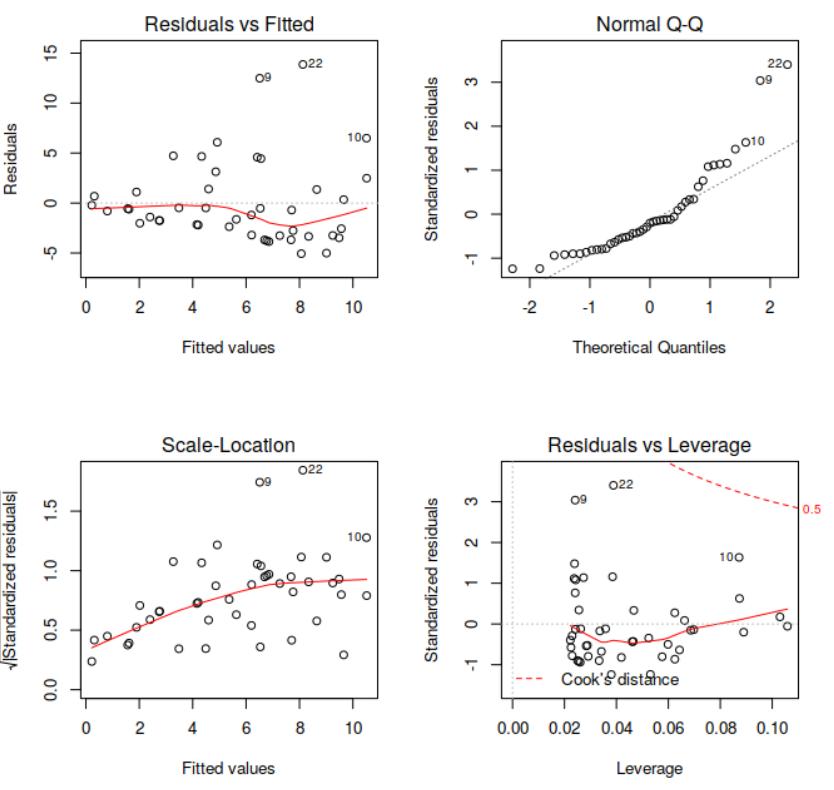
¿Qué nos dicen? En el gráfico Scale-Location la línea roja sube: la variabilidad de los residuos aumenta con los valores ajustados, así que la varianza no es constante. En el Q-Q los puntos de la derecha se despegan de la diagonal, así que los residuos tampoco son del todo normales. Y hay un par de sitios (el 9 y el 22) que se escapan bastante del resto.
Esto tiene sentido: la riqueza es un conteo (cantidad de especies), y los conteos rara vez se portan como una variable normal. No es el mejor modelo para estos datos. En la cuarta parte de la serie vamos a ver una alternativa mejor.
¿Y si la variable explicativa es categórica?
En RIKZ no tenemos una variable categórica a mano, así que vamos a inventarla: partimos NAP en tres grupos (bajo, medio y alto) usando los terciles.
library(dplyr)
cortes <- quantile(rikz$NAP, probs = c(0.33, 0.66))
rikz <- rikz %>%
  mutate(NAPc = cut(NAP,
                    breaks = c(-Inf, cortes, Inf),
                    labels = c("bajo", "medio", "alto")))

anovasimple <- lm(Richness ~ NAPc, data = rikz)
Fijate que la función es la misma lm(): lo único que cambió es que la variable explicativa ahora es un factor. Si miramos el summary(), los coeficientes ya no son una pendiente sino contrastes entre niveles del factor. La forma más habitual de presentar estos resultados es la tabla ANOVA:
> library(car)
> Anova(anovasimple)
Anova Table (Type II tests)

Response: Richness
             Sum Sq Df F value    Pr(>F)
(Intercept) 1456.36  1 75.5023 6.247e-11 ***
NAPc         291.51  2  7.5565  0.001573 **
Residuals    810.13 42
El test F nos dice que hay diferencias en la riqueza entre los grupos de NAP, pero no entre cuáles. Para eso usamos comparaciones post hoc con el paquete emmeans:
> library(emmeans)
> ph <- emmeans(anovasimple, ~ NAPc)
> pairs(ph, adjust = "none")
 contrast     estimate  SE df t.ratio p.value
 bajo - medio     1.53 1.6 42   0.956  0.3445
 bajo - alto      6.00 1.6 42   3.741  0.0005
 medio - alto     4.47 1.6 42   2.785  0.0080
Acá pedí los p-valores sin corregir (adjust = "none"), que son los mismos que veíamos en los contrastes del summary(). Pero cuando hacemos varias comparaciones a la vez conviene ajustarlos para no acumular falsos positivos: si sacamos el adjust, pairs() usa por defecto el método de Tukey, que es bastante conservador.
Si queremos el formato de letras que se usa en muchos papers (los grupos que comparten letra no difieren), lo obtenemos con cld() del paquete multcomp:
> library(multcomp)
> cld(ph, Letters = letters)
 NAPc emmean   SE df lower.CL upper.CL .group
 alto   2.20 1.13 42  -0.0885     4.49  a
 medio  6.67 1.13 42   4.3782     8.96   b
 bajo   8.20 1.13 42   5.9115    10.49   b
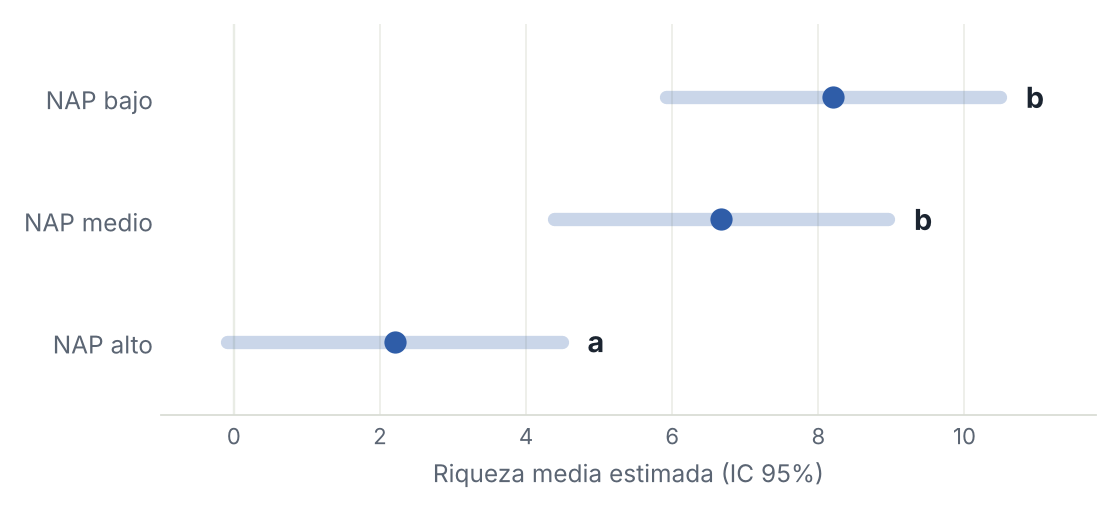
Los sitios más altos tienen menos especies que los bajos y los medios, y entre bajos y medios no hay diferencias. Es la misma historia que contaba la regresión, contada con grupos.
Más de una variable explicativa
Cuando agregamos una segunda variable aparecen dos desafíos nuevos: puede haber interacción entre ellas y puede hacer falta seleccionar cuáles dejar en el modelo.
Para verlo, imaginemos un muestreo de aves en parcelas de bosque nativo y de bosque invadido por especies exóticas, en dos alturas (piedemonte y 100 m más arriba), con 5 parcelas por combinación. Queremos saber cómo afectan el tipo de bosque y la altura a la riqueza de aves.
La interacción representa el efecto combinado de los dos factores. Si es significativa, el efecto de uno depende del nivel del otro: por ejemplo, que la invasión reduzca la riqueza en el piedemonte pero no en altura. En ese caso ya no tiene mucho sentido interpretar cada factor por separado.
En R la interacción se escribe con :, o de forma compacta con *, que incluye los efectos principales y la interacción:
mi1 <- lm(riqueza ~ Tipo_bosque + Altura + Tipo_bosque:Altura, data = aves)
# es lo mismo que
mi1 <- lm(riqueza ~ Tipo_bosque * Altura, data = aves)
¿Me quedo o no con la interacción? Para decidirlo comparamos el modelo con interacción contra uno sin ella:
mi2 <- lm(riqueza ~ Tipo_bosque + Altura, data = aves)

AIC(mi1); AIC(mi2)   # menor es mejor
BIC(mi1); BIC(mi2)   # ídem, penaliza más los modelos complejos
anova(mi1, mi2)      # test de comparación de modelos
Cuando hay varias variables, ajustar un modelo por cada combinación se vuelve tedioso. El paquete MuMIn lo hace por nosotros: ajusta todos los submodelos posibles a partir de un modelo completo y los ordena por AIC.
library(MuMIn)
m.max <- lm(riqueza ~ Tipo_bosque * Altura, data = aves, na.action = na.fail)
dredge(m.max)
Una pregunta para pensar: ¿qué efecto tiene estandarizar las variables explicativas (restarles la media y dividirlas por el desvío) sobre los coeficientes y su interpretación?
¿Y qué pongo en el paper?
Hacer bien el análisis es la mitad del trabajo; la otra mitad es contarlo. En Materiales y métodos van los métodos estadísticos usados, en Resultados los resultados de los análisis, y en la Discusión nuestra interpretación comparada con la literatura.
Las guías de análisis estadístico de la Ecological Society of America piden, entre otras cosas:
- Contar que se chequearon los supuestos de cada análisis, y cómo.
- Especificar el procedimiento y el software, con su versión. Algo tan simple como: “Todos los análisis se realizaron en R versión 4.4.1. Se utilizó una regresión lineal para evaluar la relación entre la riqueza de especies y la altura del sitio respecto del nivel del mar (NAP).” Si el método es poco común, hay que dar más detalles.
- Reportar toda la información necesaria para reconstruir el análisis, ya sea en una tabla o en el texto: estimaciones, errores estándar, estadísticos, grados de libertad y p-valores.
Para cerrar: ¿adiós al p-valor?
En los últimos años crecieron las críticas a la ciencia “p-valor-céntrica”, la que reduce todo a si p < 0.05. Revistas y sociedades científicas vienen pidiendo reportar tamaños de efecto e intervalos de confianza, y no sólo si algo dio “significativo” (ver por ejemplo Wasserstein, Schirm y Lazar, 2019, Moving to a World Beyond “p < 0.05”, en The American Statistician). La pendiente de −2.87 especies por metro nos dice mucho más sobre la playa que el p-valor que la acompaña.
En el próximo post vamos a ver qué hacer cuando la variable respuesta no es continua sino binaria: presencia o ausencia de una especie. Ahí el modelo lineal ya no alcanza y entran al campo de juego los modelos lineales generalizados.