Datos de presencia y ausencia: el GLM binomial
Regresión logística, odds ratio y deviance con datos ecológicos
Este es el segundo post de la serie basada en el curso R aplicado a Ecología: de individuos a comunidades. En el anterior vimos cómo ajustar, chequear y reportar un modelo lineal. Pero en ecología muchas veces la pregunta no es cuánto sino si: ¿la especie está o no está en el sitio? Hoy vamos a ver cómo modelar una variable respuesta binaria.
¿Qué hacer cuando los supuestos no se cumplen?
Cuando los datos no cumplen los supuestos del modelo lineal, la salida clásica es transformarlos: logaritmo, raíz cuadrada, arcoseno. Pero esto tiene dos problemas:
- A menudo no existe una única transformación que permita cumplir todos los supuestos a la vez.
- Las interpretaciones hay que hacerlas en términos de la variable transformada, que casi nunca es lo que nos interesa.
Una mejor alternativa son los modelos lineales generalizados (GLM, por Generalized Linear Models), propuestos por Nelder y Wedderburn en 1972. Igual que el modelo lineal, modelan el promedio de Y en función de variables explicativas continuas o categóricas, pero admiten otras distribuciones para la variable respuesta: binomial, Poisson, binomial negativa, exponencial, gamma.
Las tres partes de un GLM
Todo GLM tiene tres componentes:
- Componente aleatoria: identifica a la variable respuesta y su distribución de probabilidad.
- Componente sistemática: el predictor lineal, es decir, la combinación de variables explicativas del modelo: η = β₀ + β₁x₁ + … + βₖxₖ.
- Función de enlace: conecta las dos anteriores. Relaciona el valor esperado de la respuesta con el predictor lineal mediante g(μ) = η.
El modelo lineal del post anterior es el caso más simple de GLM: la respuesta tiene distribución normal, Y ~ N(μ, σ²), y la función de enlace es la identidad, g(μ) = μ. Es decir que la media de Y es directamente el predictor lineal: μ = β₀ + β₁x.
Datos binarios
Cuando la variable respuesta consiste en dos eventos mutuamente excluyentes (presente o ausente, vivo o muerto) usamos un GLM binomial. Los datos pueden venir de dos formas:
- No agrupados: cada observación es un 0 o un 1 (distribución Bernoulli).
- Agrupados: para cada combinación de variables explicativas tenemos el total de 1 y de 0 (distribución binomial).
No agrupados
| Y | X |
|---|---|
| 1 | Control |
| 0 | Control |
| 0 | Control |
| 1 | Incendiado |
| 1 | Incendiado |
| 1 | Incendiado |
Agrupados
| Presentes | Ausentes | X |
|---|---|---|
| 1 | 2 | Control |
| 3 | 0 | Incendiado |
Los dos formatos tienen la misma información, y R puede ajustar el modelo con cualquiera de ellos.
El ejemplo: Scolelepis squamata en las playas de RIKZ
Volvemos al dataset RIKZ del post anterior, pero ahora vamos a modelar la presencia del poliqueto Scolelepis squamata en función de NAP. En la tabla original tenemos la abundancia de la especie, así que la dicotomizamos: 1 si está presente (abundancia > 0) y 0 si está ausente.
library(dplyr)
rikz <- rikz %>% mutate(S.squamata = as.numeric(P16 > 0))
Identifiquemos las tres partes del GLM:
- Componente aleatoria: la presencia de S. squamata en el sitio i sigue una distribución Bernoulli, Yᵢ ~ B(1, pᵢ).
- Componente sistemática: η = β₀ + β₁ · NAP.
- Función de enlace: el logit, que vemos enseguida.
¿Qué representa la media de Y en este caso? Es la probabilidad de “éxito”: E(Y) = p = P(Y = 1), la probabilidad de que S. squamata esté presente. Lo que buscamos modelar es cómo cambia esa probabilidad con NAP.
¿Por qué no ajustar una regresión lineal?
Hay tres razones:
- La variable respuesta no sigue una distribución normal.
- La varianza no es constante: Var(Yᵢ) = pᵢ(1 − pᵢ), así que depende de pᵢ, que a su vez depende del valor de x.
- Una recta toma valores en toda la recta numérica, pero una probabilidad tiene que estar entre 0 y 1. No podemos asumir que E(Yᵢ) = β₀ + β₁xᵢ.
La curva logística
En general, un cambio en x tiene menos impacto cuando la probabilidad está cerca de 0 o de 1 que cuando está cerca de 0.5. Por eso la relación entre p(x) y x suele tener forma de S. Hay varias curvas con esa forma, pero la más usada es la logística:
p(x) = exp(β₀ + β₁x) / [1 + exp(β₀ + β₁x)]
Que también se puede escribir así:
log[ p(x) / (1 − p(x)) ] = β₀ + β₁x
Ese logaritmo de la izquierda es el logit, nuestra función de enlace. Lo importante es que, para cualquier valor de β₀ y β₁, la probabilidad siempre queda entre 0 y 1. Por eso a este modelo también se lo conoce como regresión logística.
Ajustar el modelo en R
La sintaxis es casi igual a la de lm(). Cambiamos a glm() y le indicamos la distribución con family:
squa.mod <- glm(S.squamata ~ NAP, family = "binomial", data = rikz)
> summary(squa.mod)
Coefficients:
            Estimate Std. Error z value Pr(>|z|)
(Intercept)   2.6829     0.8406   3.192 0.001414 **
NAP          -2.8389     0.8392  -3.383 0.000718 ***

(Dispersion parameter for binomial family taken to be 1)

    Null deviance: 55.799  on 44  degrees of freedom
Residual deviance: 26.866  on 43  degrees of freedom
AIC: 30.866

Number of Fisher Scoring iterations: 6
El p-valor de NAP nos dice que hay una relación significativa entre la presencia de S. squamata y la altura del sitio. Con los coeficientes podemos escribir el modelo, que está en la escala del logit:
logit(p) = 2.68 − 2.84 × NAP
Si lo pasamos a la escala de probabilidad, tenemos la curva:
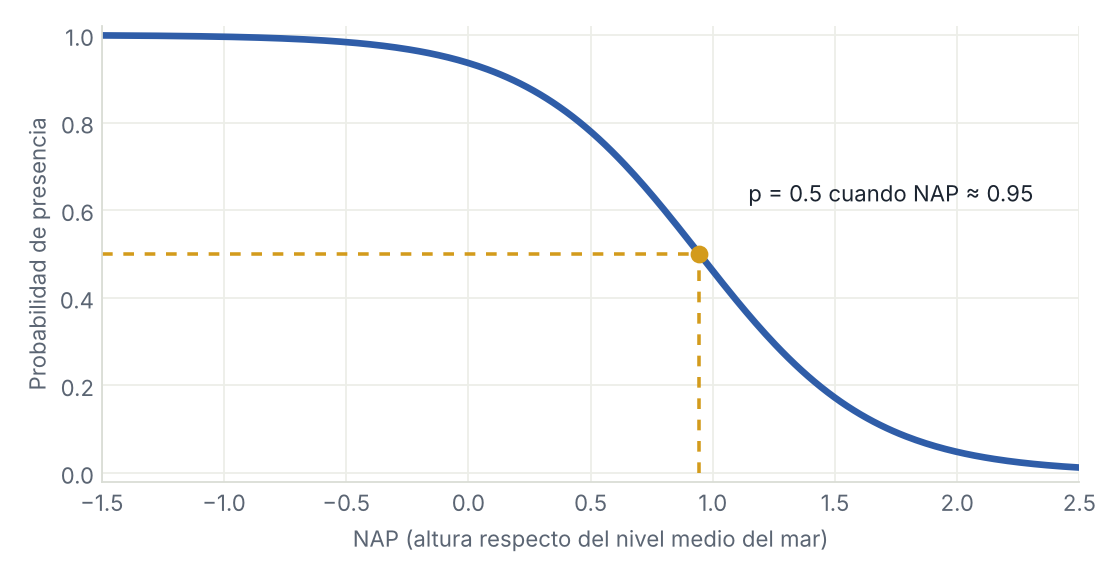
En los sitios más bajos la especie está presente casi con seguridad; a partir de NAP ≈ 0.95 es más probable no encontrarla.
Odds ratio: los coeficientes en términos de chances
En un GLM binomial los coeficientes se interpretan en términos de odds (chances): el cociente entre la probabilidad de que ocurra el evento y la de que no ocurra, p / (1 − p). Por cada incremento de una unidad en x, las chances se multiplican por exp(β₁). Ese valor es el odds ratio.
En nuestro ejemplo:
exp(−2.84) ≈ 0.058
Es decir, la chance de presencia de S. squamata se multiplica por 0.058 por cada unidad que aumenta NAP. Como un número menor a 1 es difícil de leer, es más fácil cambiar el signo e interpretarlo al revés: exp(2.84) ≈ 17. La chance de presencia de S. squamata aumenta unas 17 veces por cada unidad que disminuye NAP.
El odds ratio es un concepto MUY utilizado en medicina pero bastante ignorado en ecología. Y vale la pena: mientras el p-valor nos dice si hay o no una asociación, el odds ratio es una medida del tamaño del efecto.
Midiendo la bondad de ajuste: la deviance
En un GLM ya no hablamos de suma de cuadrados sino de deviance. Para entenderla necesitamos dos modelos de referencia:
- Modelo nulo: tiene un solo parámetro (la media general) y toda la variabilidad se atribuye a la componente aleatoria. Es trivial.
- Modelo saturado: tiene un parámetro por observación y toda la variabilidad se atribuye a la componente sistemática. Ajusta perfecto, pero no nos dice nada.
La deviance de nuestro modelo compara su verosimilitud con la del modelo saturado:
D = 2 × [ log L(modelo saturado) − log L(modelo en estudio) ]
Un valor pequeño indica que, con muchos menos parámetros, logramos un ajuste casi tan bueno como el del modelo saturado. En la salida del summary() vemos que la deviance baja de 55.8 en el modelo nulo a 26.9 al incluir NAP.
En el próximo post vamos a cuestionar algo que dimos por sentado en todo este análisis: que cuando no vimos a la especie es porque no estaba. Ahí entran al campo de juego los modelos de ocupación.