Que no la veas no significa que no esté: modelos de ocupación
Cómo separar la presencia de una especie de nuestra capacidad de detectarla
Este es el tercer post de la serie basada en el curso R aplicado a Ecología: de individuos a comunidades. En el anterior modelamos la presencia de una especie con un GLM binomial. Pero en ese análisis dimos por sentado algo que en el campo casi nunca es cierto, y de eso se trata este post.
El supuesto escondido
Hasta ahora asumimos que la presencia o ausencia de la especie se detecta de forma perfecta. Es decir, si no vimos a la especie X en el sitio Y es porque no está ahí.
Pero puede pasar que la especie esté en el sitio y que nuestro método de muestreo haya fallado en detectarla: el animal estaba escondido, era de noche, llovía, el observador estaba cansado. Esto se conoce como detección imperfecta, y es lo que buscan modelar los modelos de ocupación.
“If a tree falls in the forest, but there is no one there to see it, does it make any noise?” (koan zen)
“If a bird sings in the forest, but the investigator fails to detect it, is the forest occupied?” (Evan Cooch)
Dos procesos en simultáneo
MacKenzie y colaboradores plantean que en un muestreo ocurren dos procesos a la vez:
- Ocupación (ψ): la presencia o ausencia de la especie en los sitios durante el período de muestreo (la “temporada”). Es lo que nos interesa.
- Detectabilidad (p): depende de los protocolos de muestreo. Es un parámetro “de ruido”, pero si lo ignoramos nos sesga todo lo demás.
La ocupación ψ es la probabilidad de que un sitio elegido al azar dentro del área de estudio esté ocupado por la especie, es decir, que contenga al menos un individuo.
Si la detección fuera perfecta, la podríamos estimar simplemente como la proporción de sitios donde vimos a la especie:
ψ ≈ sitios con la especie / sitios totales
Pero con detección imperfecta las cosas cambian. Si detectamos a la especie en un sitio, su presencia está confirmada. Si no la detectamos, hay dos posibilidades: está ausente, o está pero no la pudimos detectar.
¿Cómo distinguimos una de otra? Muchos biólogos de campo llegaron a la misma respuesta: visitar el mismo sitio varias veces. Si en k visitas la probabilidad de detectar a la especie en cada una es p, la probabilidad de detectarla al menos una vez es p* = 1 − (1 − p)ᵏ, y la ocupación se estima como:
ψ ≈ sitios donde se detectó la especie / (sitios totales × p*)
Como p* es menor que 1, la ocupación estimada es siempre mayor o igual que la proporción observada. Y la incertidumbre de la estimación tiene ahora dos fuentes: la variación debida a la ocupación y la debida a la detección imperfecta.
Covariables en dos niveles
Igual que en un GLM, tanto la ocupación como la detección pueden depender de covariables, y en los dos casos se usa el enlace logit que vimos en el post anterior:
- Ocupación, con covariables del sitio: logit(ψᵢ) = β₀ + β₁xᵢ
- Detección, con covariables del sitio o de cada visita: logit(pᵢⱼ) = α₀ + α₁xᵢⱼ
Por ejemplo, el tipo de hábitat puede afectar la ocupación, mientras que el clima del día, la hora o el observador pueden afectar la detección.
Supuestos
- La ocupación no cambia durante la temporada de muestreo. La temporada es un período en el que la especie no debería colonizar ni abandonar los sitios. Según la especie, puede ir desde unas semanas hasta unos 3 meses.
- Los sitios son independientes. Como en el modelo lineal, esto se garantiza con un buen diseño de muestreo (aleatorizado, estratificado, etc.).
- La probabilidad de ocupación no cambia entre sitios, o si cambia, lo explican las covariables.
- La probabilidad de detección no cambia entre sitios ni entre visitas, o si cambia, lo explican las covariables.
Los dos últimos supuestos tienen una consecuencia práctica: hay que registrar todo lo posible sobre el muestreo. ¿Llovió? ¿Estuvo soleado? ¿A qué distancia del camino principal está la transecta? Si no se cumplen los supuestos, las estimaciones de ocupación y detectabilidad pueden estar sesgadas y las inferencias pueden ser incorrectas.
Ejemplo: el weta gigante
El weta gigante (Deinacrida mahoenui) es un insecto endémico de Nueva Zelanda. En 2004 se hizo un estudio en una reserva con este diseño:
- 72 parcelas circulares de 3 m de radio.
- Cada parcela se visitó entre 3 y 5 veces durante un período de 5 días (3.6 veces en promedio).
- Hubo tres observadores, y cada uno visitó cada parcela al menos una vez. Así se buscó evitar que la detección dependiera de un único observador.
Se detectaron wetas en 35 de las 72 parcelas, lo que da una ocupación naïve de 0.49. Pero muchas veces se las detectó en solo una o dos de las visitas, lo que indica que la probabilidad de detección es menor a 1. Es decir que puede haber otras parcelas donde la especie estaba pero no se la pudo detectar.
Las variables que vamos a considerar son:
- Para la ocupación: Browse, si hay ramoneo de cabras en la vegetación donde viven las wetas.
- Para la detección: el observador, el día y Browse.
Preparar los datos
Vamos a usar el paquete unmarked, que trae este dataset incluido. Los modelos de ocupación necesitan los datos separados en tres partes: la matriz de detecciones (un sitio por fila, una visita por columna), las covariables de sitio y las covariables de cada visita.
library(unmarked)
library(dplyr)
data(weta)

## Matriz de detecciones
pres <- weta %>% select(day1:day5)

## Covariables de ocupación
covas <- weta %>% select(Browse)

## Covariables de detección
obs <- as.factor(with(weta, c(obs.day1, obs.day2, obs.day3,
                              obs.day4, obs.day5)))

covas_obs <- data.frame(
    Site = rep(1:nrow(pres), ncol(pres)),
    Day  = rep(c("D1", "D2", "D3", "D4", "D5"), each = nrow(pres)),
    Obs  = obs)

covas_obs <- covas_obs %>% arrange(Site)
Con las tres partes armamos un objeto unmarkedFrameOccu:
> weta.umf <- unmarkedFrameOccu(y = pres,
                                siteCovs = covas,
                                obsCovs = covas_obs)
> summary(weta.umf)
72 sites
Max. # of obs. per site: 5
Mean # of obs. per site: 3.64
Sites w/ at least 1 detection: 35

Site-level covariates:
     Browse
 Browsed  :35
 Unbrowsed:37

Observation-level covariates:
      Site        Day       Obs
 Min.   : 1.00   D1:72   Obs1:91
 1st Qu.:18.75   D2:72   Obs2:81
 Median :36.50   D3:72   Obs3:90
 Mean   :36.50   D4:72   NA's:98
 3rd Qu.:54.25   D5:72
 Max.   :72.00
Los 98 NA del observador corresponden a las visitas que no se hicieron: no todas las parcelas se visitaron los 5 días.
Ajustar y seleccionar el modelo
La función occu() recibe una fórmula doble: primero las covariables de la detección y después las de la ocupación.
mw.max <- occu(~ Day + Obs + Browse   # detección
               ~ Browse,              # ocupación
               weta.umf)
Para elegir qué variables dejar usamos dredge() del paquete MuMIn, como en el primer post de la serie:
> dredge(mw.max, rank = AIC)
Fixed terms are "p(Int)" and "psi(Int)"
Global model call: occu(formula = ~Day + Obs + Browse ~ Browse, data = weta.umf)
---
Model selection table
    p(Int) psi(Int) p(Brw) p(Day) p(Obs) psi(Brw) df   logLik   AIC delta weight
15 -1.3000   1.1930             +      +        + 9 -119.800 257.6 0.00 0.276
7  -1.3430   0.5804             +      +          8 -121.273 258.5 0.95 0.172
8  -1.1980   0.7375      +      +      +          9 -120.707 259.4 1.82 0.111
11 -0.6100   1.2080             +               + 7 -122.718 259.4 1.84 0.110
16 -1.3020   1.1960      +      +      +        + 10 -119.800 259.6 2.00 0.101
3  -0.6212   0.5311             +                 6 -124.397 260.8 3.20 0.056
...
Models ranked by AIC(x)
El modelo con menor AIC incluye el día y el observador para la detección, y el ramoneo para la ocupación. Igual conviene mirar la columna delta: hay varios modelos a menos de 2 unidades de AIC del mejor que explicarían igual de bien los datos.
Leer la salida
> mwf <- occu(~ Day + Obs ~ Browse, weta.umf)
> summary(mwf)
Call:
occu(formula = ~Day + Obs ~ Browse, data = weta.umf)

Occupancy (logit-scale):
                Estimate    SE     z P(>|z|)
(Intercept)         1.19 0.676  1.77  0.0774
BrowseUnbrowsed    -1.17 0.741 -1.58  0.1147

Detection (logit-scale):
            Estimate    SE      z P(>|z|)
(Intercept)  -1.2997 0.525 -2.477  0.0132
DayD2        -0.1549 0.550 -0.281  0.7784
DayD3        -0.9432 0.600 -1.573  0.1158
DayD4        -0.0707 0.563 -0.126  0.9001
DayD5         1.0354 0.564  1.836  0.0663
ObsObs2       0.7265 0.468  1.553  0.1205
ObsObs3       1.0700 0.460  2.326  0.0200
La salida tiene dos tablas, una para cada proceso, y las dos están en escala logit.
Ocupación. Si volvemos los coeficientes a la escala de probabilidad, la ocupación estimada es de 0.77 en las parcelas con ramoneo y de 0.51 en las sin ramoneo. La diferencia no es significativa (p = 0.11), pero la variable quedó en el modelo porque mejora el AIC.
Detección. Acá está la parte interesante: el observador 3 detecta wetas con más probabilidad que el observador 1 (p = 0.02). Usando los coeficientes, la probabilidad de detección en una visita del día 1 es de 0.21 para el observador 1, 0.36 para el 2 y 0.44 para el 3. Es muy baja: incluso el mejor observador pasa por alto a la especie en más de la mitad de las visitas a un sitio ocupado.
Esto muestra por qué importan las visitas repetidas. Si calculamos p* = 1 − (1 − p)ᵏ para cada observador, vemos cómo aumenta la probabilidad de detectar a la especie al menos una vez a medida que sumamos visitas:
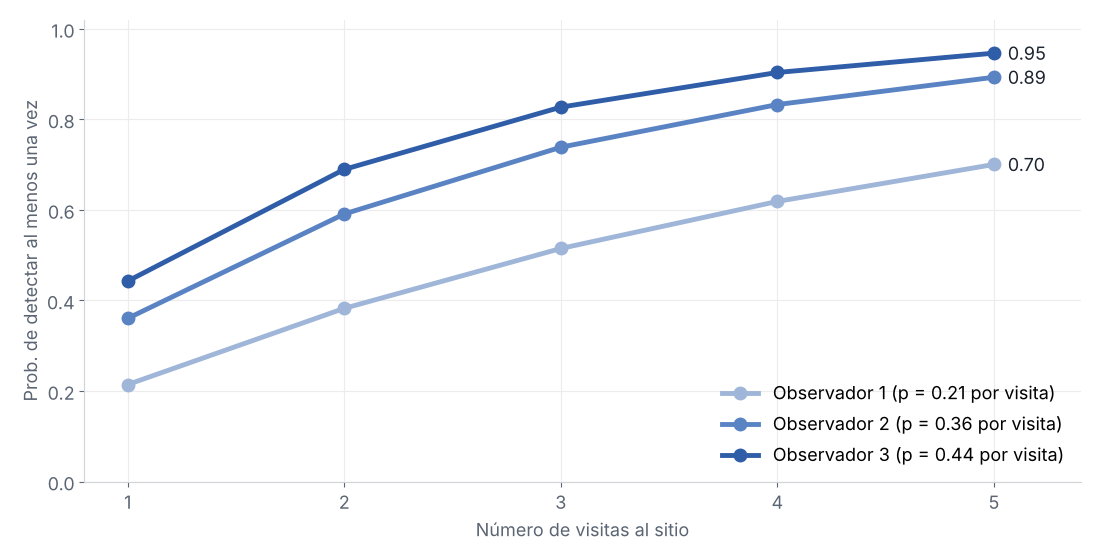
Si todas las visitas las hiciera el observador 1, con 5 visitas todavía nos perderíamos a la especie en el 30% de los sitios donde está.
Chequear el ajuste
Para evaluar el ajuste usamos un bootstrap paramétrico: simulamos muchos datasets a partir del modelo ajustado, calculamos un estadístico chi-cuadrado en cada uno y vemos si el de nuestros datos reales es atípico.
chisq <- function(fm) {
  observed <- getY(fm@data)
  expected <- fitted(fm)
  sum((observed - expected)^2 / expected, na.rm = TRUE)
}
> pb <- parboot(mwf, statistic = chisq, nsim = 100)
> pb

Parametric Bootstrap Statistics:
   t0 mean(t0 - t_B) StdDev(t0 - t_B) Pr(t_B > t0)
1 261          -2.13             13.3        0.564

t_B quantiles:
     0% 2.5% 25% 50% 75% 97.5% 100%
t*1 236  239 256 262 269   295  319

t0 = Original statistic compuated from data
t_B = Vector of bootstrap samples
El estadístico de nuestros datos (261) cae en el medio de la distribución de los simulados, y Pr(t_B > t0) es 0.56. No hay evidencia de falta de ajuste.
¿Cuántos sitios están ocupados en realidad?
Por último, comparamos la ocupación naïve con la estimada por el modelo. Para la estimada, ranef() calcula para cada sitio la distribución posterior de su estado de ocupación, y bup() nos da el valor más probable:
## Ocupación naïve
> oc.naive <- sum(rowSums(pres, na.rm = TRUE) > 0)

## Estimaciones bayesianas de ocupación
> oc.est <- sum(bup(ranef(mwf), stat = "mode"))
| Sitios ocupados | % | |
|---|---|---|
| Naïve | 35 | 48.61 |
| Estimada | 37 | 51.39 |
El modelo estima que hay al menos 2 parcelas donde las wetas estaban, pero ninguno de los observadores las vio.
Para cerrar
Los modelos de ocupación nos obligan a pensar el muestreo de otra manera. Ya no alcanza con ir una vez a cada sitio y anotar si la especie está: hay que volver, registrar quién observó, cuándo y en qué condiciones. A cambio, podemos separar lo que pasa en la naturaleza de lo que pasa con nuestros métodos de muestreo.
En el próximo y último post de la serie vamos a dejar la presencia y la ausencia y pasar a contar individuos: modelos de Poisson, sobredispersión y binomial negativa.