DataViz III: radiografía de mis lecturas
Un dataset real, de la limpieza al gráfico final
Previously on this blog… vimos cómo visualizar datos continuos y datos categóricos. A partir de un dataset de juguete fuimos conociendo diferentes gráficos. Ahora vamos a hacer algo diferente: tomar un dataset real y recorrer el camino completo desde el archivo crudo hasta los gráficos terminados.
El dataset es mi biblioteca de Goodreads, donde registro todo lo que leo desde hace años: casi 400 libros y más de 120.000 páginas. Las preguntas son las que cualquier lector se haría sobre sí mismo: ¿cuánto leo?, ¿qué leo?, ¿de dónde son los autores?, ¿leo autoras mujeres o solo hombres?, ¿coincido con el resto de los lectores en las calificaciones que doy?
Los datos
Goodreads tenía una API para descargar los datos, pero dejó de funcionar hace tiempo. Lo que sí se puede hacer es exportar la biblioteca personal desde My Books → Import and export, que genera un CSV con una fila por libro: título, autor, rating propio, rating promedio, páginas, año de publicación, fecha de lectura y reseña, entre otras cosas.
A ese archivo le agregué a mano cuatro columnas que Goodreads no tiene: el país del autor, su género, el idioma en que leí el libro y si es ficción o no ficción. Con eso quedó una planilla de Excel así:
> books_raw <- read_excel(here("Libros.xlsx"), sheet = "read")
> glimpse(books_raw)
Rows: 396
Columns: 14
$ Title                       <chr> "Probabilidad y estadística para ingeniería…
$ Author                      <chr> "Ronald E. Walpole", "Dennis G. Zill", "E.D…
$ Country                     <chr> "Estados Unidos", "Estados Unidos", "Argent…
$ Gender                      <chr> "Hombre", "Hombre", "Hombre", "Hombre", "Ho…
$ Language                    <chr> "Español", "Español", "Español", "Español",…
$ Type                        <chr> "No ficción", "No ficción", "No ficción", "…
$ `My Rating`                 <chr> "3", "3", "4", "4", "4", "3", "3", "3", "3"…
$ `Average Rating`            <chr> "3.62", "3.57", "3.96", "3.96", "3.98", "3.…
$ `Number of Pages`           <dbl> 816, 720, 469, 927, 639, 144, 127, 128, 144…
$ `Original Publication Year` <dbl> 2003, 2003, 1995, 1995, 1986, 1996, 1995, 1…
$ `Date Read`                 <chr> NA, NA, NA, NA, NA, NA, NA, NA, NA, NA, NA,…
...
Limpiar antes de graficar
Un glimpse() ya muestra varios problemas. Los ratings son texto (<chr>) en lugar de números, y la fecha de lectura también. Pero el más traicionero no se ve a simple vista: en la columna de fechas, algunas celdas decían 45452.
Ese número es una fecha en el formato interno de Excel, que cuenta los días desde el 30/12/1899 (45452 es el 9 de junio de 2024). Pasa cuando en una misma columna conviven celdas con formato de fecha y celdas con texto: read_excel lee toda la columna como texto, y las fechas “de verdad” quedan convertidas en ese número. La solución es convertir los dos casos por separado:
books <- books_raw %>%
  mutate(
    `Date Read` = {
      num <- suppressWarnings(as.numeric(`Date Read`))   # sólo los seriales de Excel
      case_when(
        !is.na(num) ~ as_date(num, origin = "1899-12-30"),
        TRUE        ~ as_date(parse_date_time(`Date Read`, orders = c("ymd", "mdy"),
                                              quiet = TRUE))
      )
    },
    Year_read  = year(`Date Read`),
    Month_read = month(`Date Read`, label = TRUE, abbr = TRUE),
    across(c(`My Rating`, `Average Rating`), as.numeric),
    `My Rating` = na_if(`My Rating`, 0),   # 0 = sin calificar en Goodreads
    Gender = factor(Gender, levels = c("Mujer", "Hombre"))
  )
Dos detalles más. En Goodreads un rating de 0 no significa “malísimo” sino “sin calificar”, así que lo pasamos a NA para que no arrastre los promedios hacia abajo. Y la fecha de lectura falta en muchos libros (los que registré de memoria, sin saber cuándo los leí), así que todos los análisis por año van a usar solo los libros con fecha, que arrancan en 2021.
Un esqueleto para todos los gráficos
Antes de graficar armé tres piezas que se reusan en casi todo el post. La primera es una función que muestra el gráfico y lo guarda con un nombre, para no exportar a mano:
mostrar <- function(p, nombre, w = 8, h = 5) {
  ggsave(file.path(dir_fig, paste0(nombre, ".png")), p, width = w, height = h, dpi = 300)
  print(p)
  invisible(p)
}
La segunda es una “capa” para todos los gráficos con años en el eje X. En ggplot2 se puede guardar una lista de componentes y sumarla con + como si fuera uno solo:
anios <- anio_desde:anio_actual
capa_anios <- list(
  scale_x_continuous(breaks = anios,
                     labels = ifelse(anios == anio_actual, paste0(anios, "*"), anios),
                     expand = expansion(mult = c(0.05, 0.25))),
  scale_y_continuous(expand = expansion(mult = c(0.05, 0.12))),
  coord_cartesian(clip = "off"),
  labs(caption = paste0("* ", anio_actual, " en curso (hasta el ",
                        format(today(), "%d/%m"), ")"))
)
Esta capa resuelve un problema que aparece en cualquier serie temporal armada en el medio del año: el último año está incompleto, y si no se aclara, la caída de la última barra o del último punto parece una tendencia.
La tercera pieza es un filtro para etiquetar solo el último punto de cada línea, que vamos a usar enseguida:
ultimo_punto <- function(df) filter(df, Year_read == max(Year_read))
¿Cuánto leo?
Empecemos por lo básico, libros y páginas por año:
bp_year <- books_recent %>%
  group_by(Year_read) %>%
  summarize(Books = n(), Pages = sum(`Number of Pages`, na.rm = TRUE))

# Factor de escala para el eje secundario (redondeado a centenas)
k <- ceiling(max(bp_year$Pages) / max(bp_year$Books) / 100) * 100

ggplot(bp_year, aes(x = Year_read)) +
  geom_line(aes(y = Books), color = "blue", linewidth = 1.2) +
  geom_point(aes(y = Books), color = "blue", size = 4) +
  geom_text(aes(y = Books, label = Books), vjust = -1, color = "white") +
  geom_line(aes(y = Pages / k), color = "red", linewidth = 1.2) +
  geom_point(aes(y = Pages / k), color = "red", size = 4) +
  geom_text(aes(y = Pages / k, label = Pages), vjust = -1, color = "white") +
  geom_text(data = ultimo_punto, aes(y = Books, label = "libros"),
            hjust = 0, nudge_x = 0.15, size = 5, color = "white") +
  geom_text(data = ultimo_punto, aes(y = Pages / k, label = "páginas"),
            hjust = 0, nudge_x = 0.15, size = 5, color = "white") +
  capa_anios +
  scale_y_continuous(sec.axis = sec_axis(~ . * k, name = "Páginas"),
                     expand = expansion(mult = c(0, 0.15))) +
  xlab("Año") + ylab("Libros") +
  theme_dark_blue()
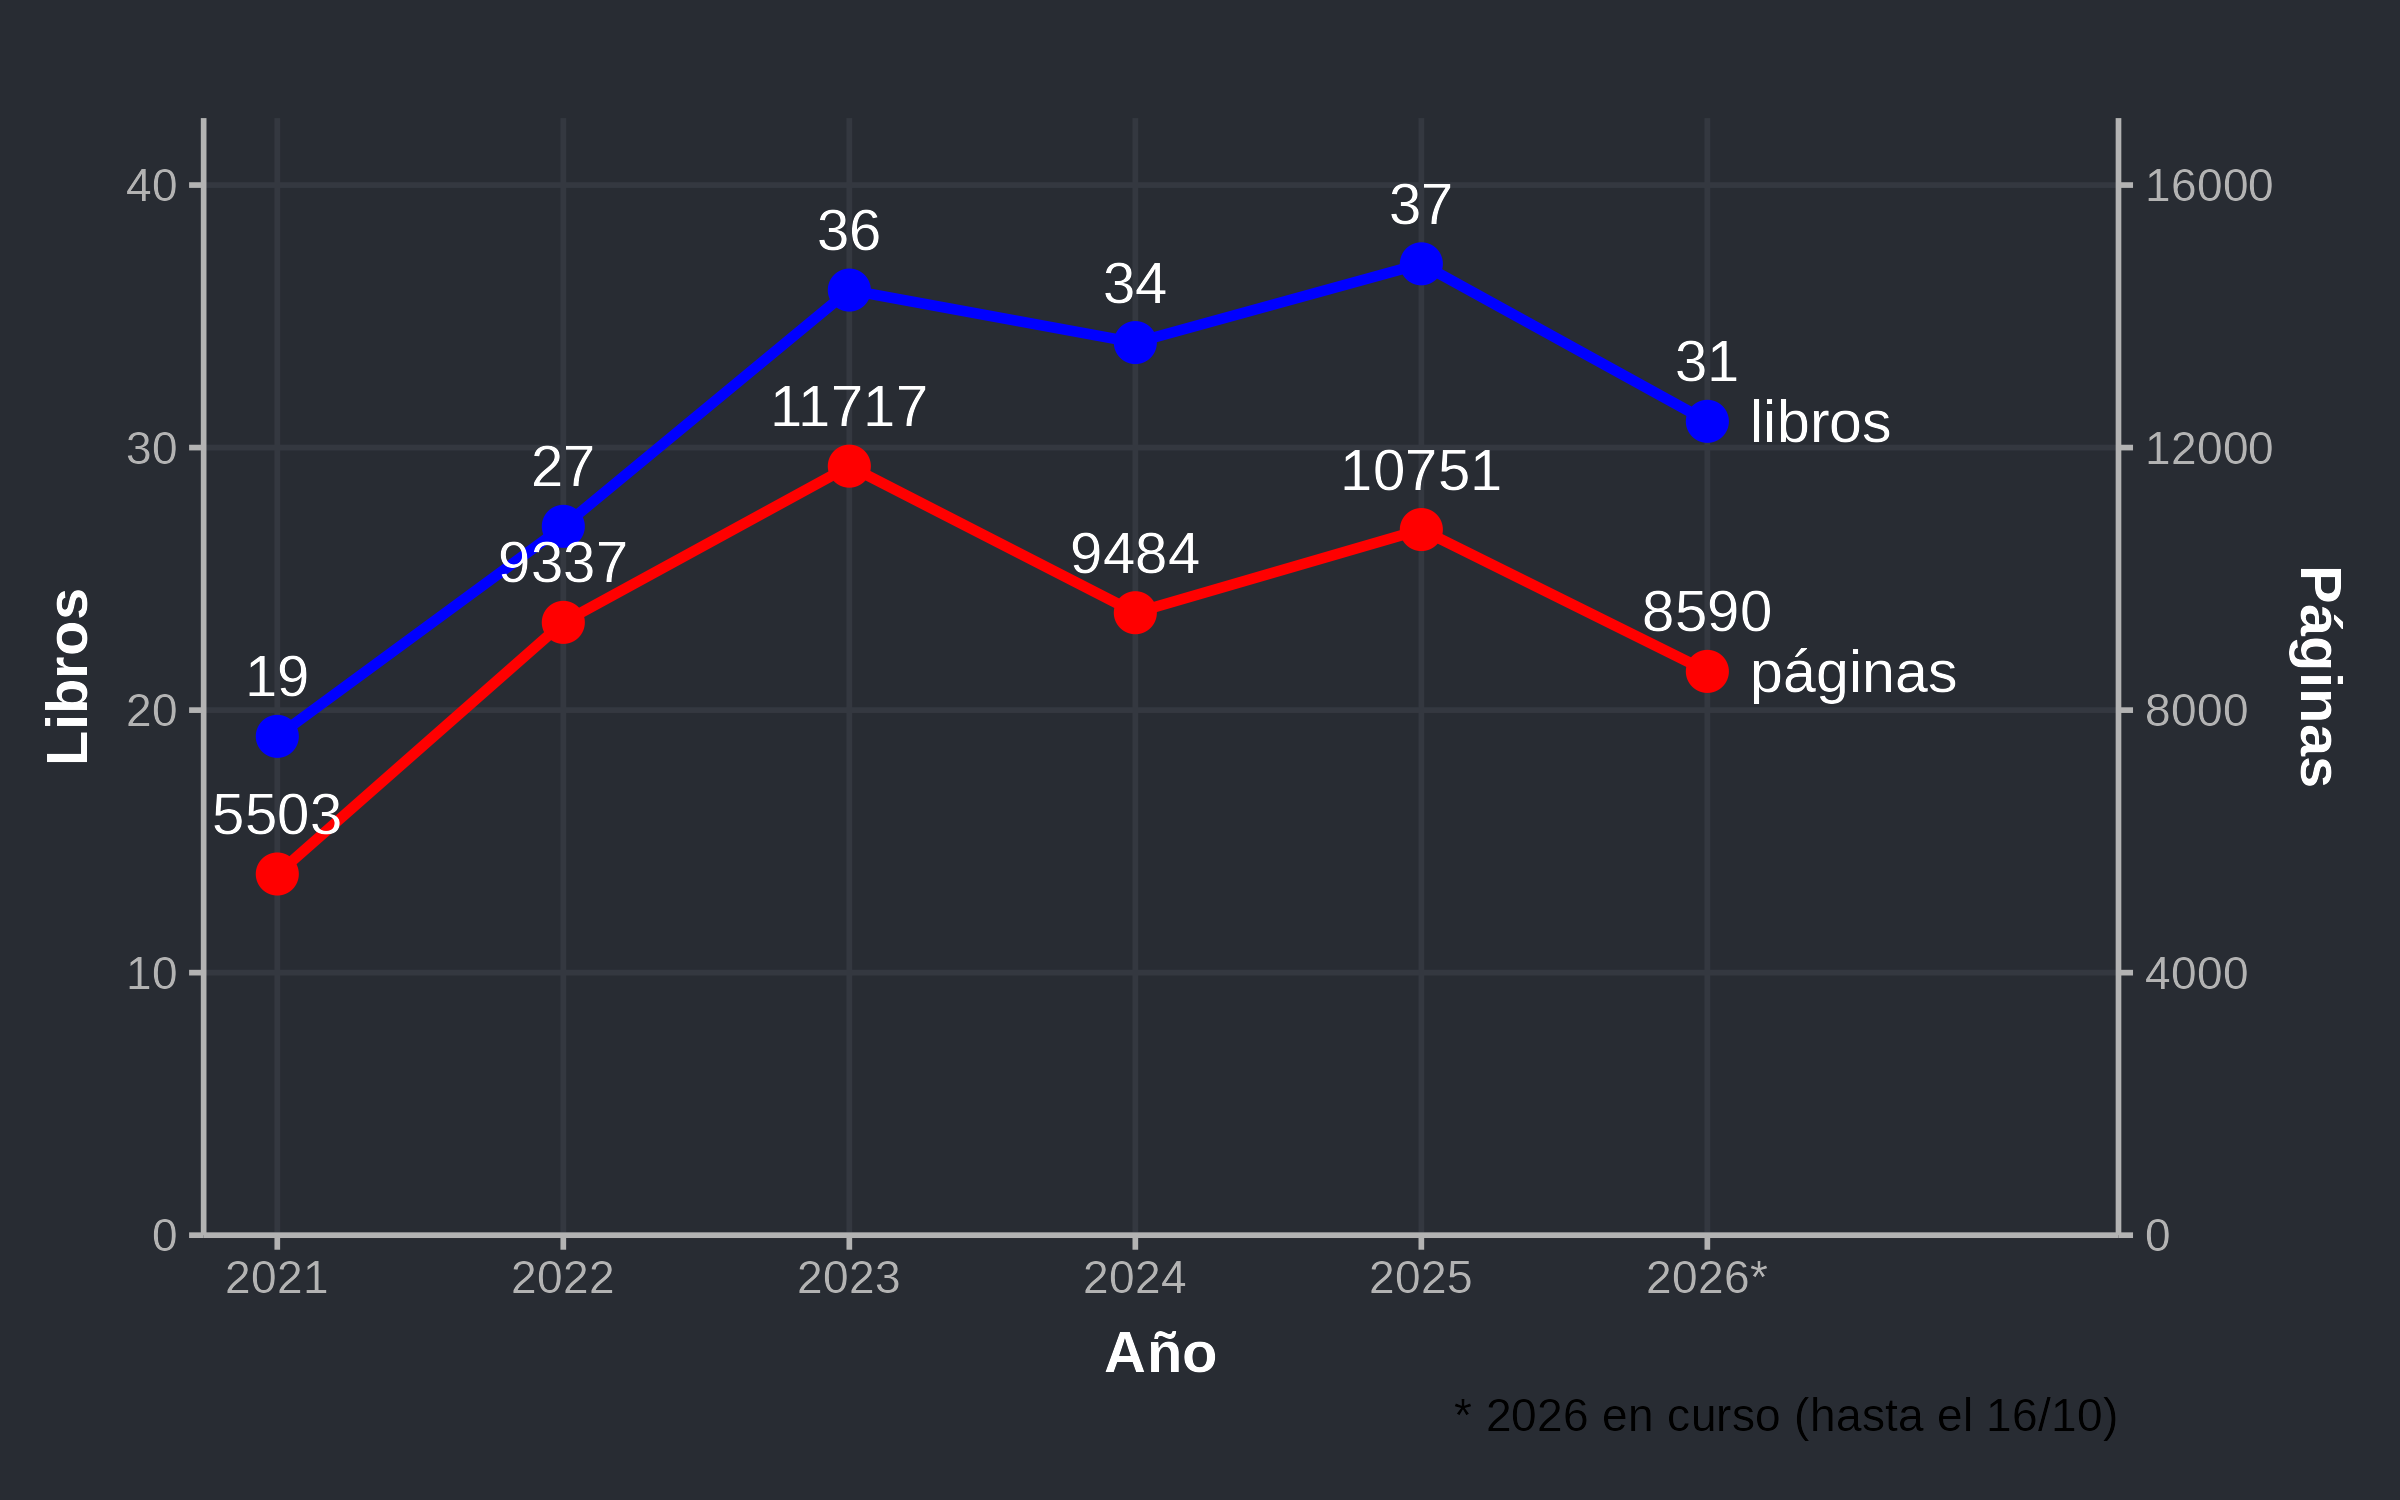
Nota: el doble eje es polémico pero en algunos casos como éste le veo cierta utilidad.
Del gráfico sale que pasé de 19 libros en 2021 a unos 35 por año desde 2023. Pero los totales anuales esconden cuándo leí. Para eso sirve el acumulado: una línea por año con la cantidad de libros que llevaba leídos en cada día del calendario.
acum <- books_recent %>%
  arrange(`Date Read`) %>%
  group_by(Year_read) %>%
  mutate(dia = yday(`Date Read`), acumulado = row_number()) %>%
  ungroup()

ggplot(acum, aes(x = dia, y = acumulado, color = factor(Year_read),
                 linewidth = Year_read == anio_actual)) +
  geom_step() +
  geom_vline(xintercept = hoy_yday, linetype = "dashed", color = "grey70") +
  geom_text(data = acum %>% group_by(Year_read) %>% slice_max(dia, n = 1, with_ties = FALSE),
            aes(label = Year_read), hjust = -0.2, size = 4, show.legend = FALSE) +
  scale_linewidth_manual(values = c(`FALSE` = 0.7, `TRUE` = 1.8), guide = "none") +
  scale_x_continuous(breaks = yday(as_date(paste0(anio_actual, "-", 1:12, "-01"))),
                     labels = month.abb, expand = expansion(mult = c(0.02, 0.08))) +
  xlab("") + ylab("Libros acumulados") +
  theme_dark_blue() +
  theme(legend.position = "none")
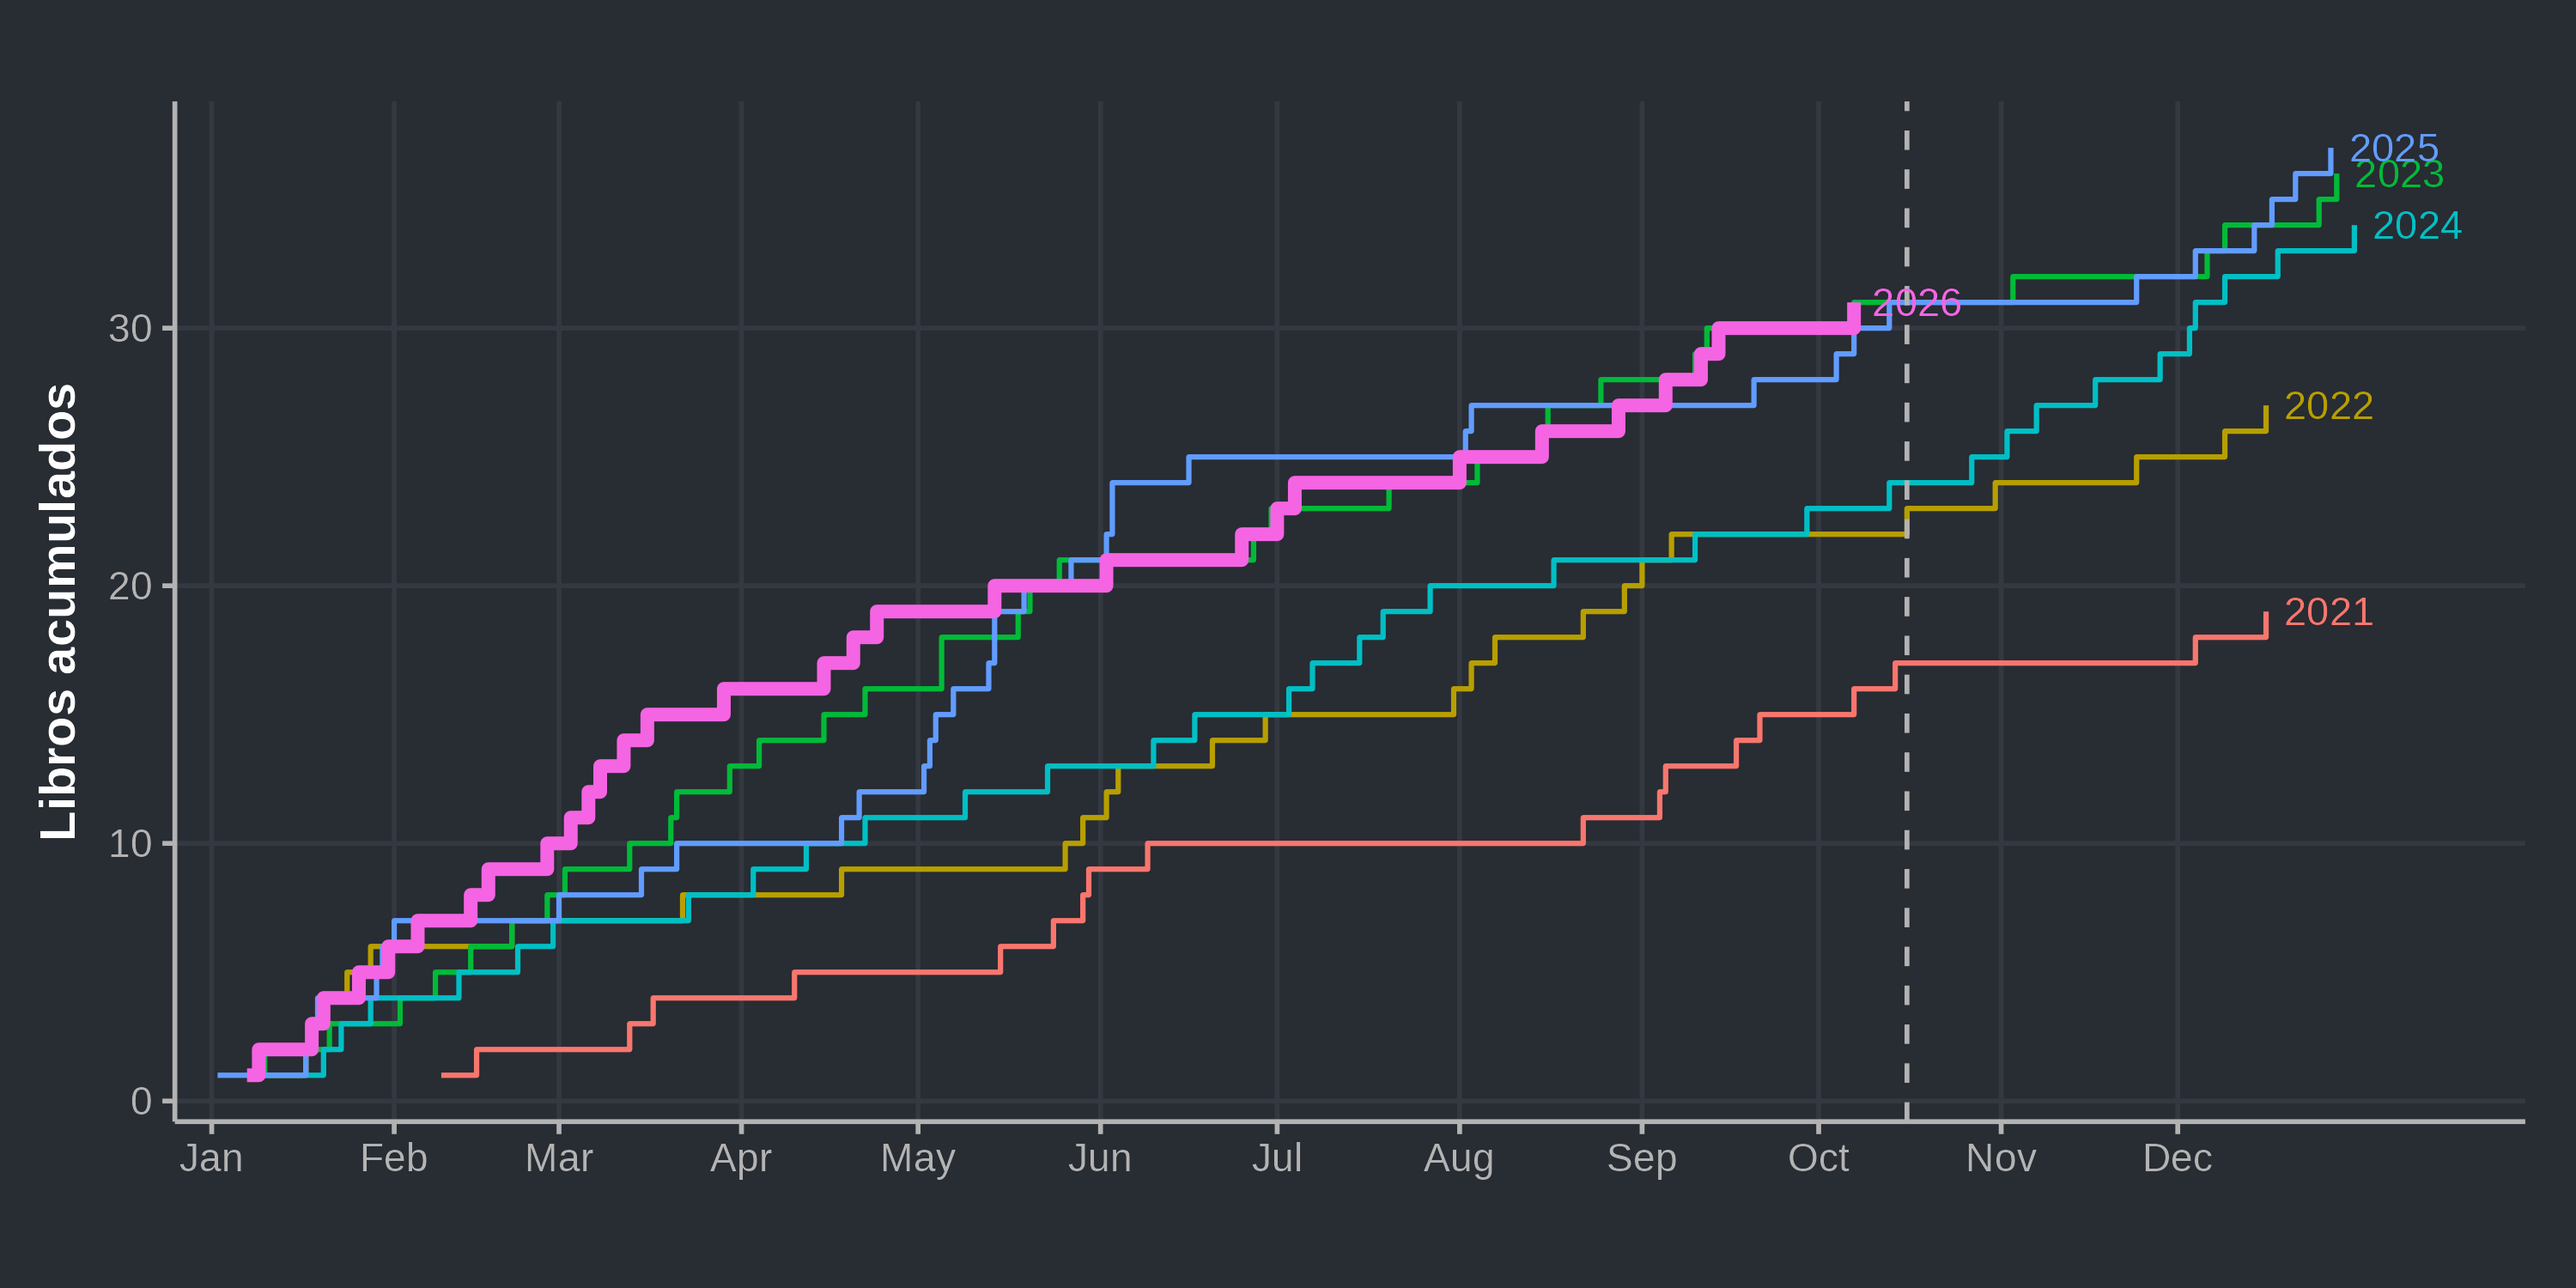
La línea punteada marca el día de hoy, así que se puede comparar cómo viene 2026 contra los años anteriores a la misma altura del calendario. 2026 arrancó más rápido que cualquier otro año y a mitad de octubre está empatado con 2023 y 2025, los dos mejores.
Este gráfico tiene algo de carrera, así que pedía una animación. Con gganimate alcanza con agregar una transición al gráfico. transition_reveal() va dibujando las líneas a medida que avanza la variable que le indiquemos, en este caso el día del año:
library(gganimate)

# acum_anim es `acum` con un punto en el día 0 para cada año y los años
# terminados extendidos hasta el 31/12 (ver el script completo al final)
anim <- ggplot(acum_anim, aes(x = dia, y = acumulado, group = anio, color = anio)) +
  geom_line(aes(linewidth = actual)) +
  geom_point(size = 3) +
  geom_text(aes(label = etiqueta), hjust = -0.3, size = 4.5, show.legend = FALSE) +
  scale_linewidth_manual(values = c(`FALSE` = 0.8, `TRUE` = 2), guide = "none") +
  scale_x_continuous(breaks = yday(as_date(paste0("2025-", 1:12, "-01"))),
                     labels = month.abb, limits = c(0, 400)) +
  labs(title = "{format(as_date(max(1, round(frame_along)), origin = '2024-12-31'), '%d/%m')}",
       x = "", y = "Libros acumulados") +
  theme_dark_blue() +
  theme(legend.position = "none") +
  transition_reveal(dia)

animacion <- animate(anim, nframes = 200, fps = 20, end_pause = 40,
                     width = 1200, height = 740, res = 150,
                     device = "ragg_png", renderer = gifski_renderer())
anim_save("acumulado_animado.gif", animacion)
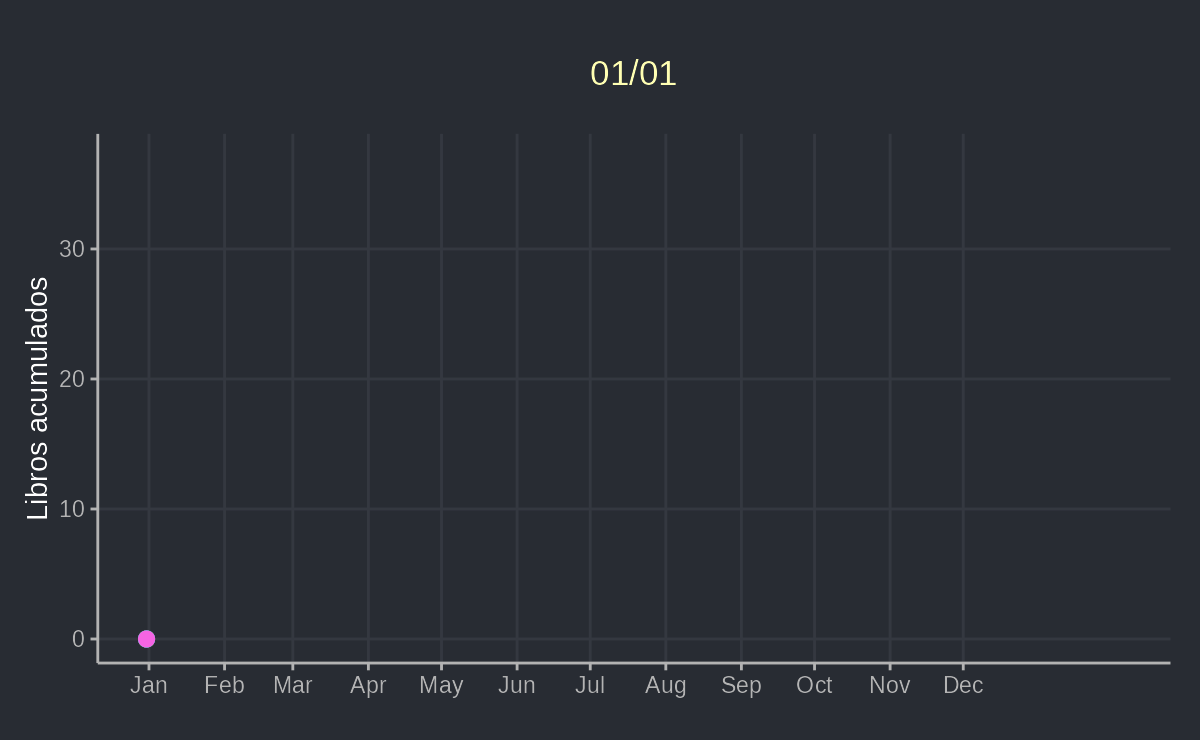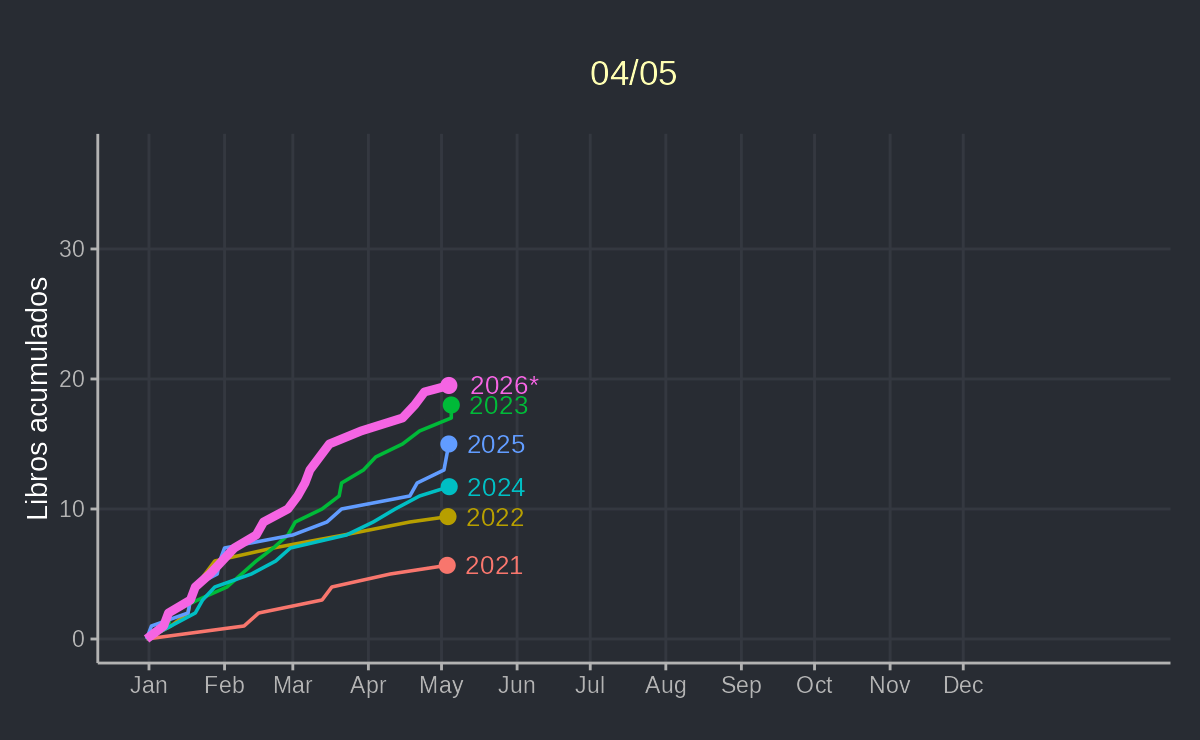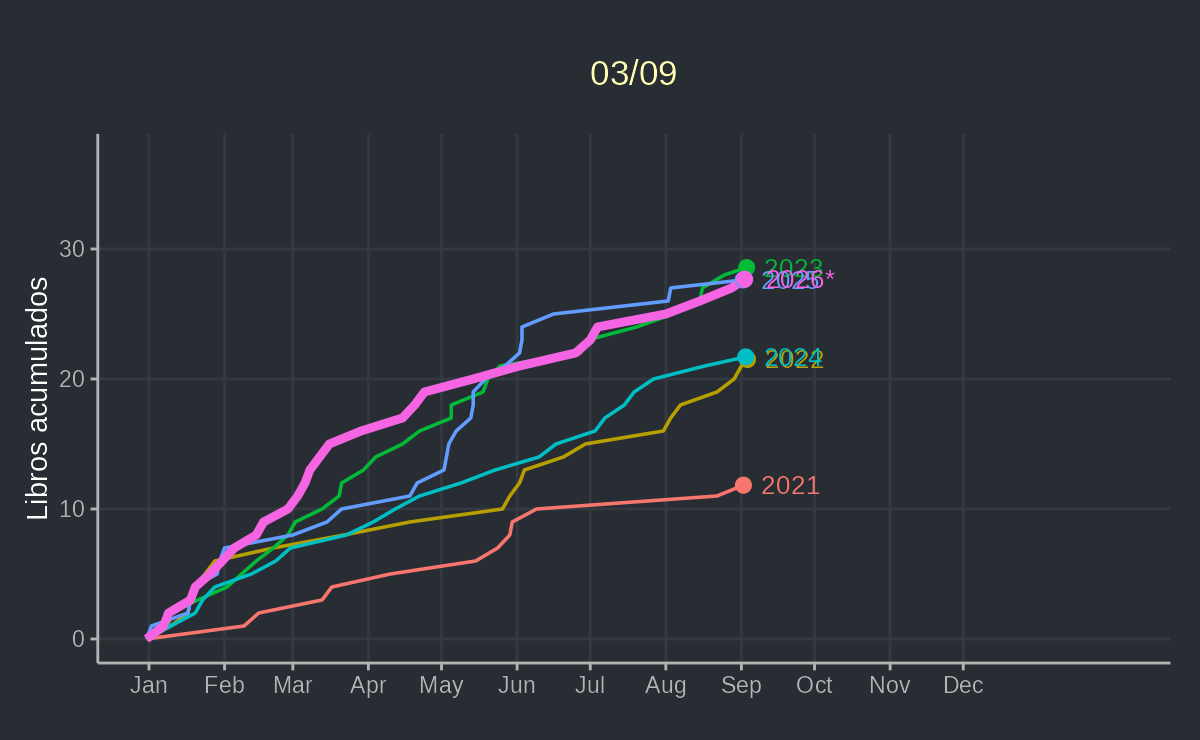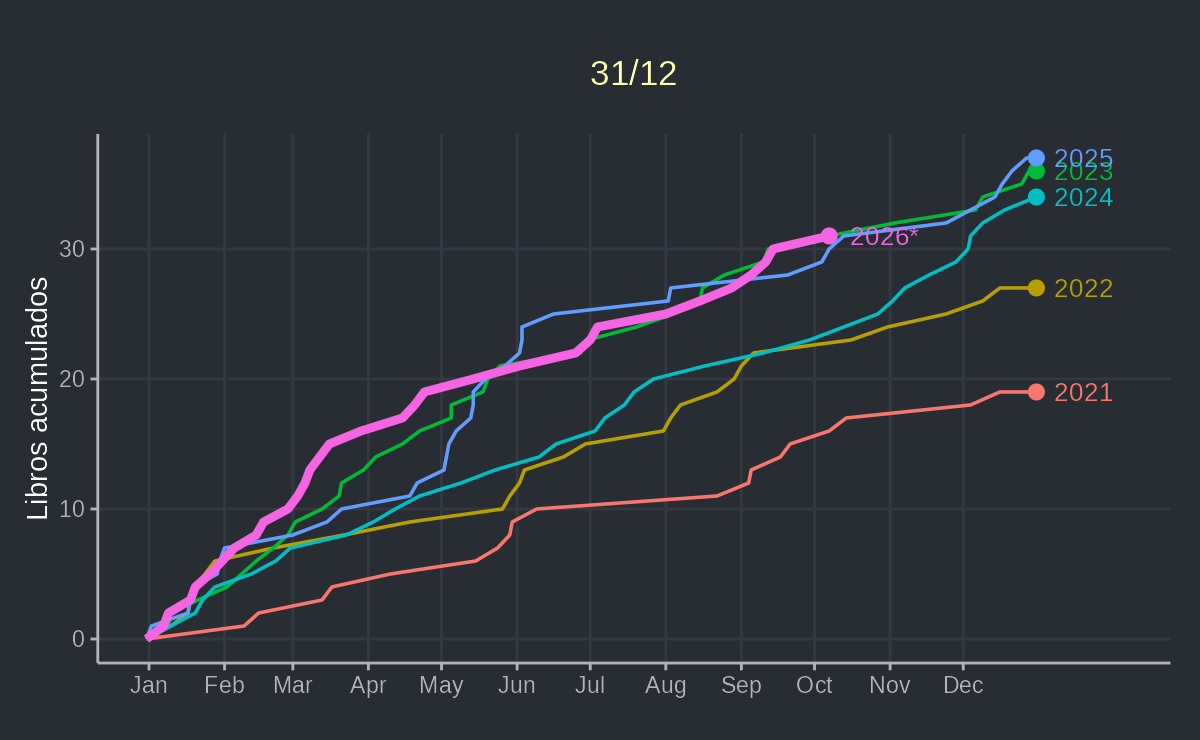
¿Y en qué meses leo más? Un gráfico de barras por mes respondería eso, pero perdería los años. Un heatmap con años en las filas y meses en las columnas muestra las dos cosas a la vez:
# Etiqueta de año con "*" para el año en curso
lab_anio <- function(x) ifelse(x == anio_actual, paste0(x, "*"), x)

heat <- books_recent %>%
  count(Year_read, Month_read) %>%
  complete(Year_read, Month_read, fill = list(n = 0)) %>%
  # Los meses que todavía no pasaron quedan vacíos, no en cero
  mutate(n = if_else(Year_read == anio_actual & as.integer(Month_read) > month(today()),
                     NA_integer_, n),
         Year_read = factor(Year_read, levels = rev(anios), labels = lab_anio(rev(anios))))

max_n <- max(heat$n, na.rm = TRUE)

ggplot(heat, aes(x = Month_read, y = Year_read, fill = n)) +
  geom_tile(color = "grey15", linewidth = 1) +
  geom_text(aes(label = if_else(n > 0, as.character(n), ""),
                color = if_else(n > max_n * 0.6, "grey10", "white")),
            size = 4, na.rm = TRUE) +
  scale_fill_viridis_c(option = "mako", begin = 0.15, na.value = "transparent",
                       name = "Libros") +
  scale_color_identity() +
  coord_fixed() +
  xlab("") + ylab("") +
  theme_dark_blue() +
  theme(panel.grid = element_blank(), axis.line = element_blank(),
        axis.ticks = element_blank())
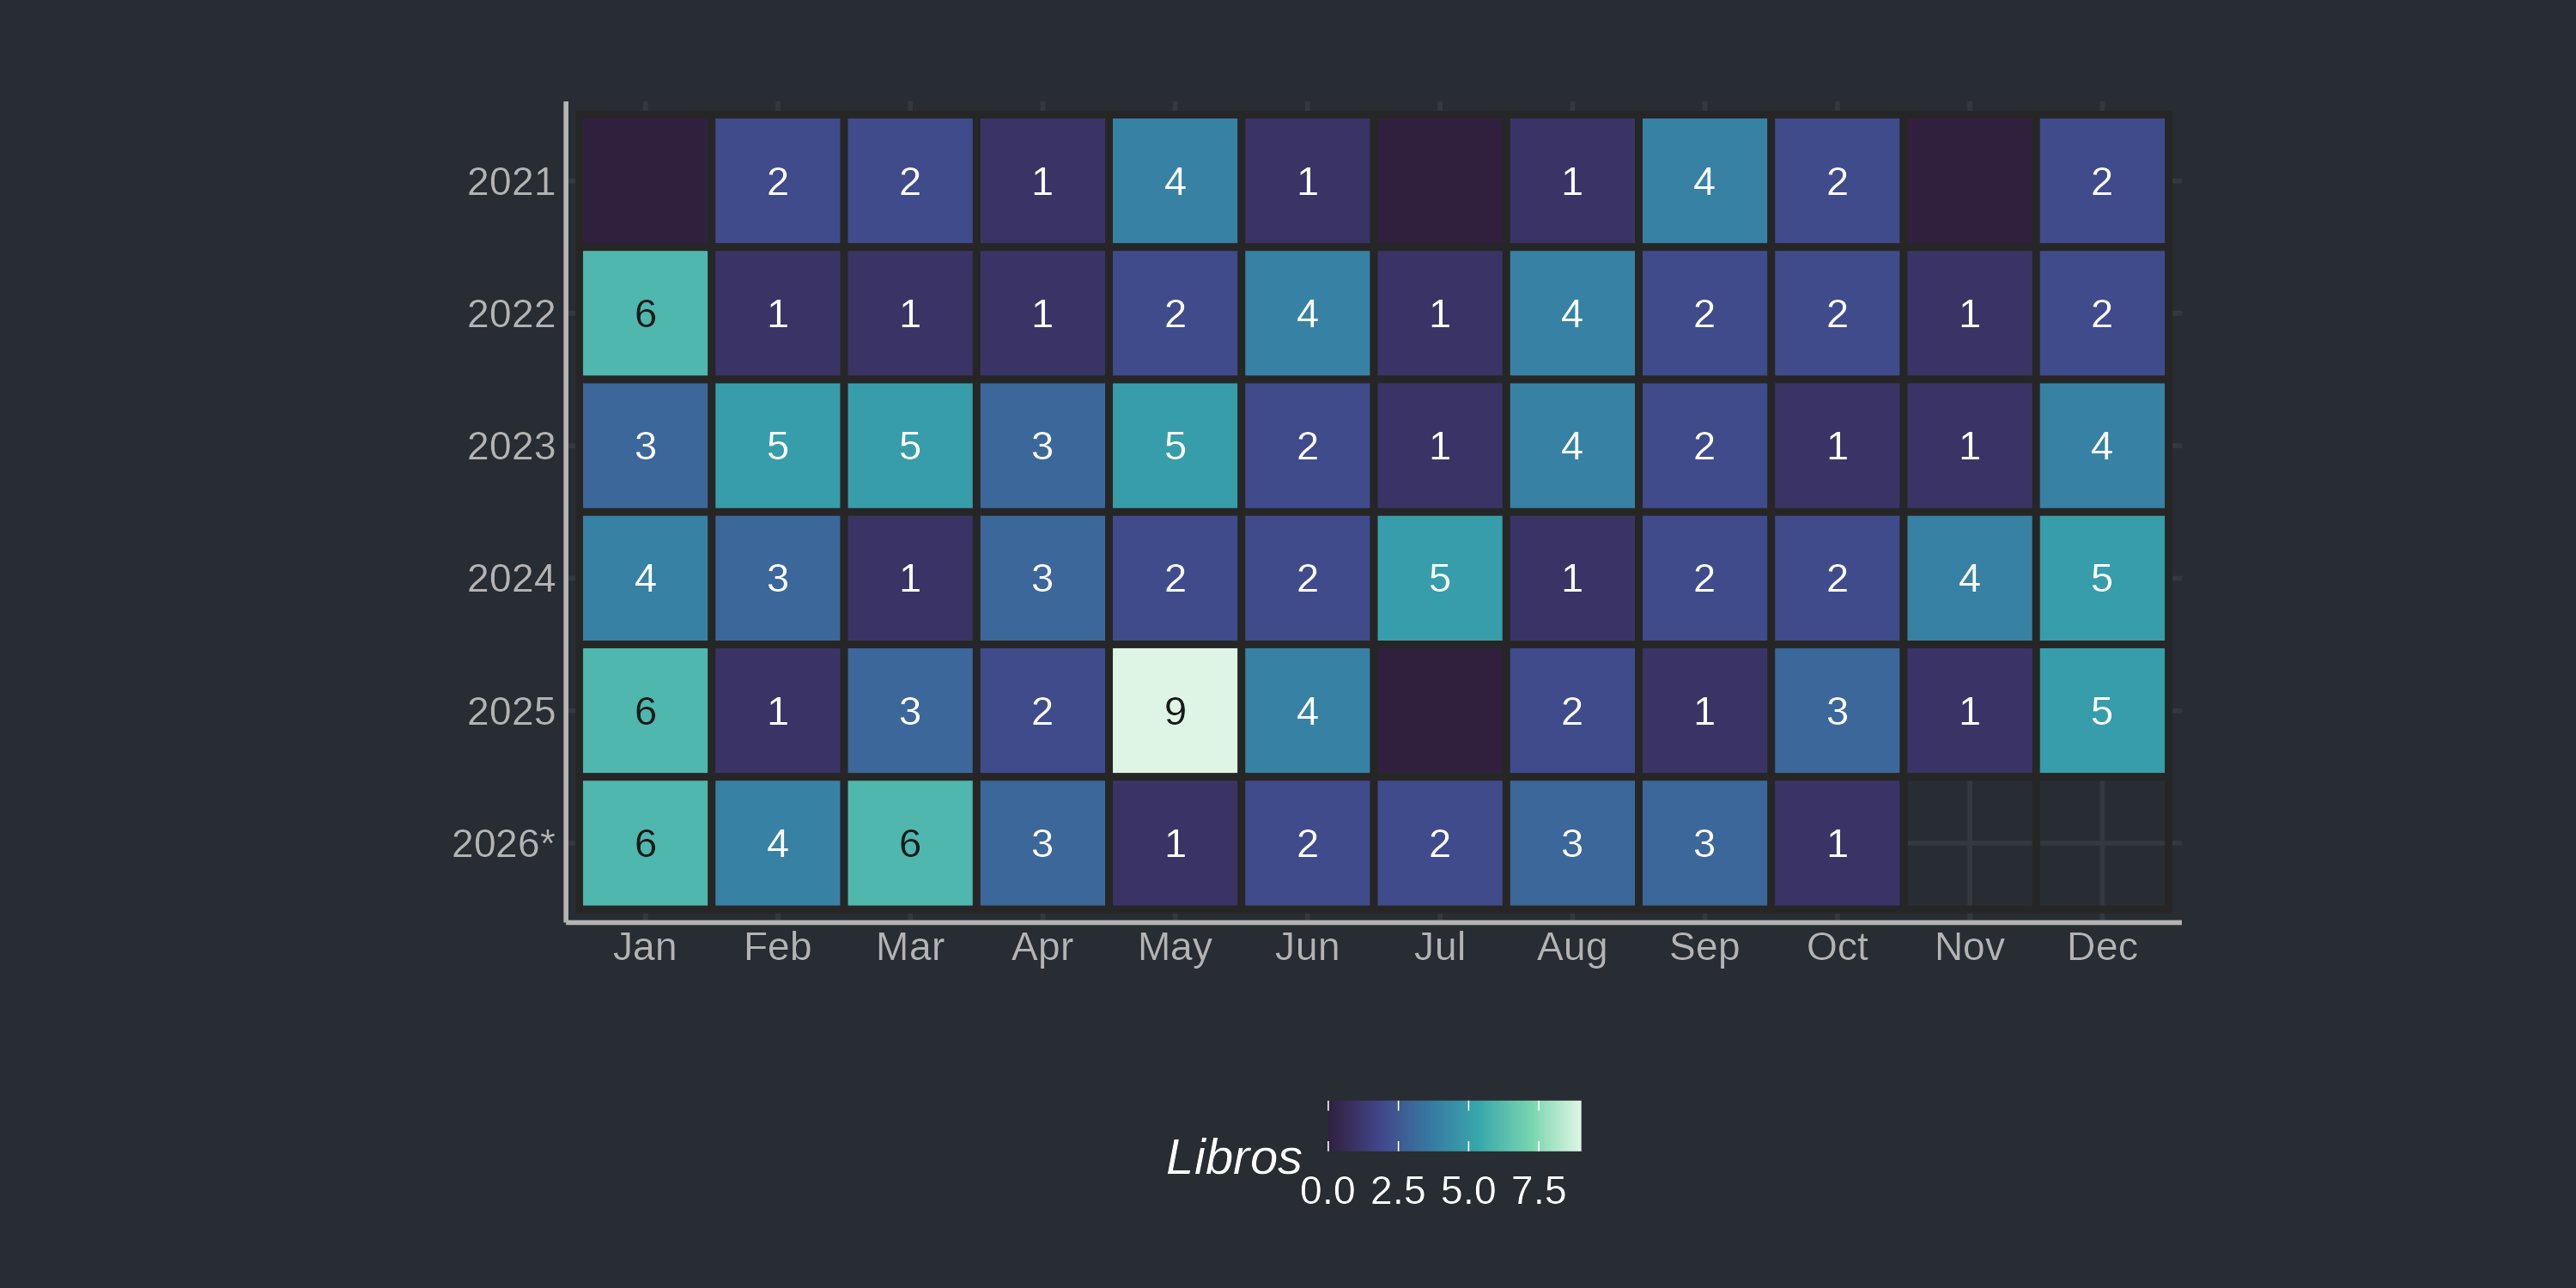
Se puede ver que durante el verano (especialmente diciembre y enero) es cuando más libros termino.
¿Qué leo?
La primera división es ficción contra no ficción:
fnf_year <- books_recent %>%
  count(Type, Year_read) %>%
  complete(Type, Year_read, fill = list(n = 0))

ggplot(fnf_year, aes(x = Year_read, y = n, color = Type, group = Type)) +
  geom_line(linewidth = 1.2) +
  geom_point(size = 4) +
  geom_text(aes(label = n), vjust = -1) +
  geom_text(data = ultimo_punto, aes(label = str_to_lower(Type)),
            hjust = 0, nudge_x = 0.15, size = 5, color = "white") +
  expand_limits(y = 0) +
  capa_anios +
  xlab("Año") + ylab("Libros") +
  theme_dark_blue() +
  theme(legend.position = "none")
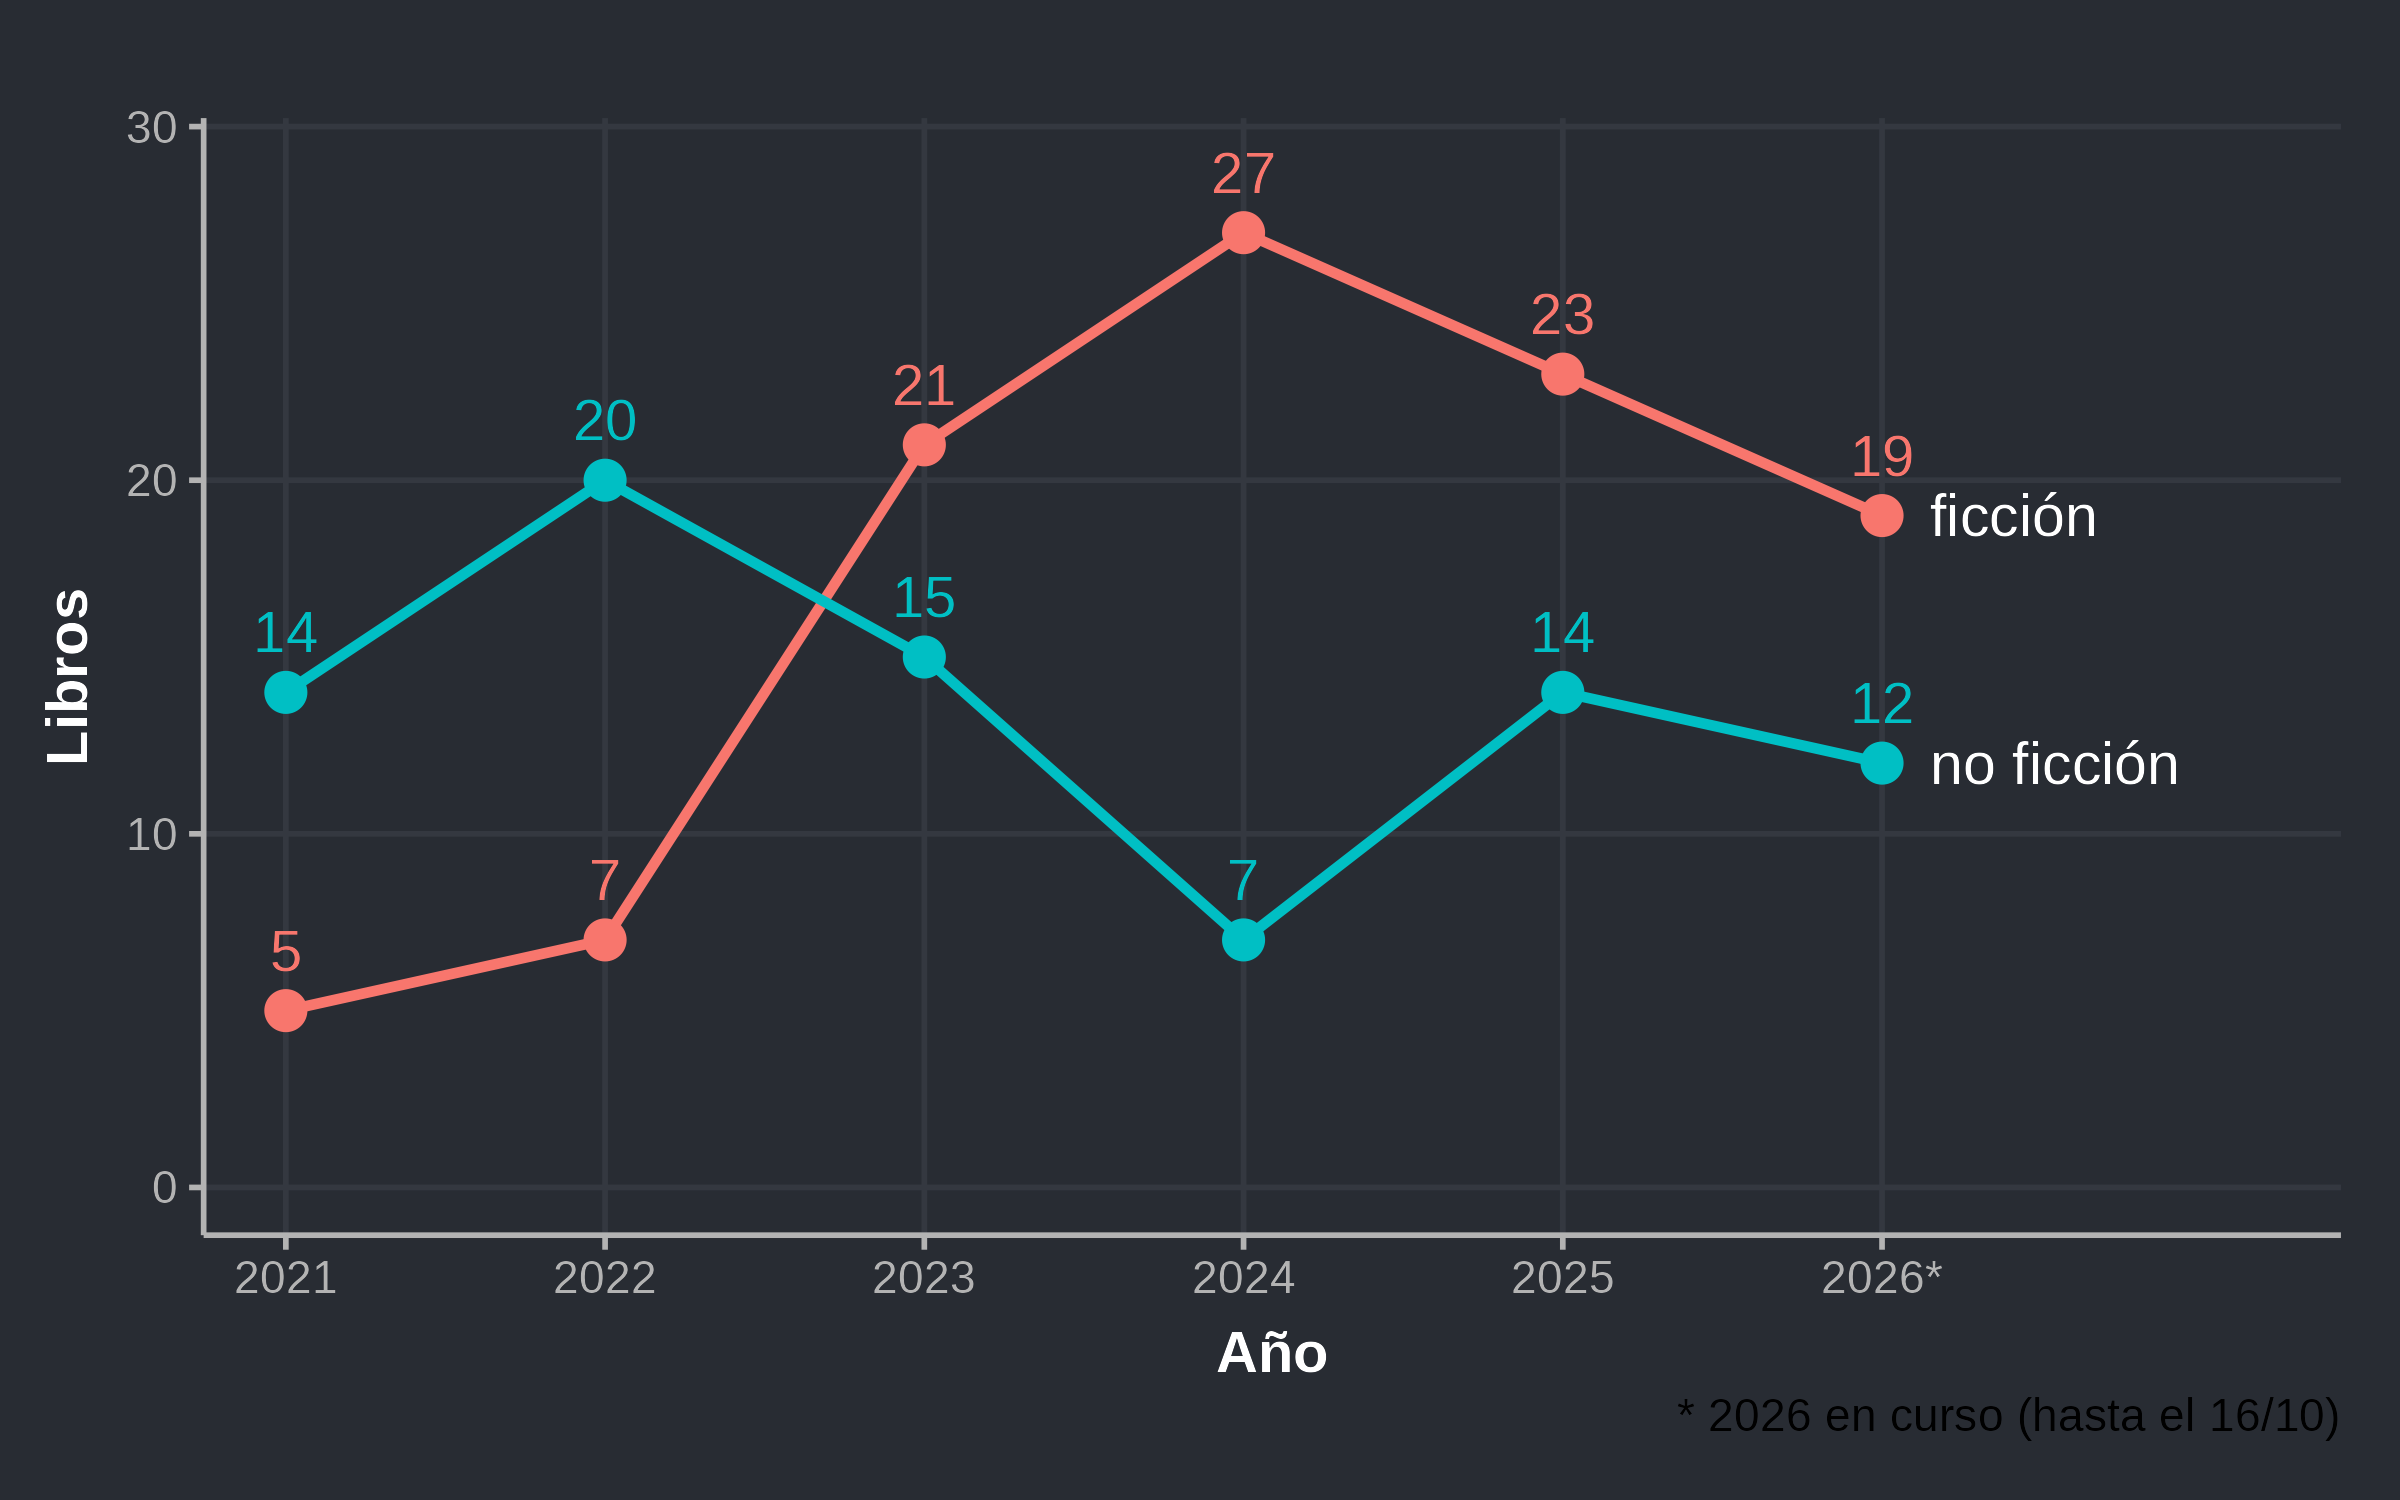
Hasta 2022 leía más no ficción, y en 2023 se cruzaron las líneas.
¿Y qué tan largos son los libros? En DataViz I vimos histogramas y boxplots. Una herramienta que no apareció ahí son los facets (o small multiples): el mismo gráfico repetido en paneles, uno por grupo, todos con la misma escala.
medianas <- books_recent %>%
  group_by(Year_read) %>%
  summarize(mediana = median(`Number of Pages`, na.rm = TRUE))

books_recent %>%
  filter(!is.na(`Number of Pages`)) %>%
  ggplot(aes(x = `Number of Pages`, fill = Type)) +
  geom_histogram(binwidth = 100, boundary = 0, color = "grey15", alpha = 0.8) +
  geom_vline(data = medianas, aes(xintercept = mediana),
             linetype = "dashed", color = "white") +
  geom_text(data = medianas, aes(x = mediana, y = Inf, label = paste("mediana:", mediana)),
            inherit.aes = FALSE, hjust = -0.1, vjust = 1.5, size = 3, color = "white") +
  facet_wrap(~ Year_read, nrow = 2, labeller = as_labeller(lab_anio)) +
  scale_y_continuous(expand = expansion(mult = c(0, 0.15))) +
  xlab("Páginas") + ylab("Libros") +
  theme_dark_blue() +
  theme(legend.position = "bottom", legend.title = element_blank())
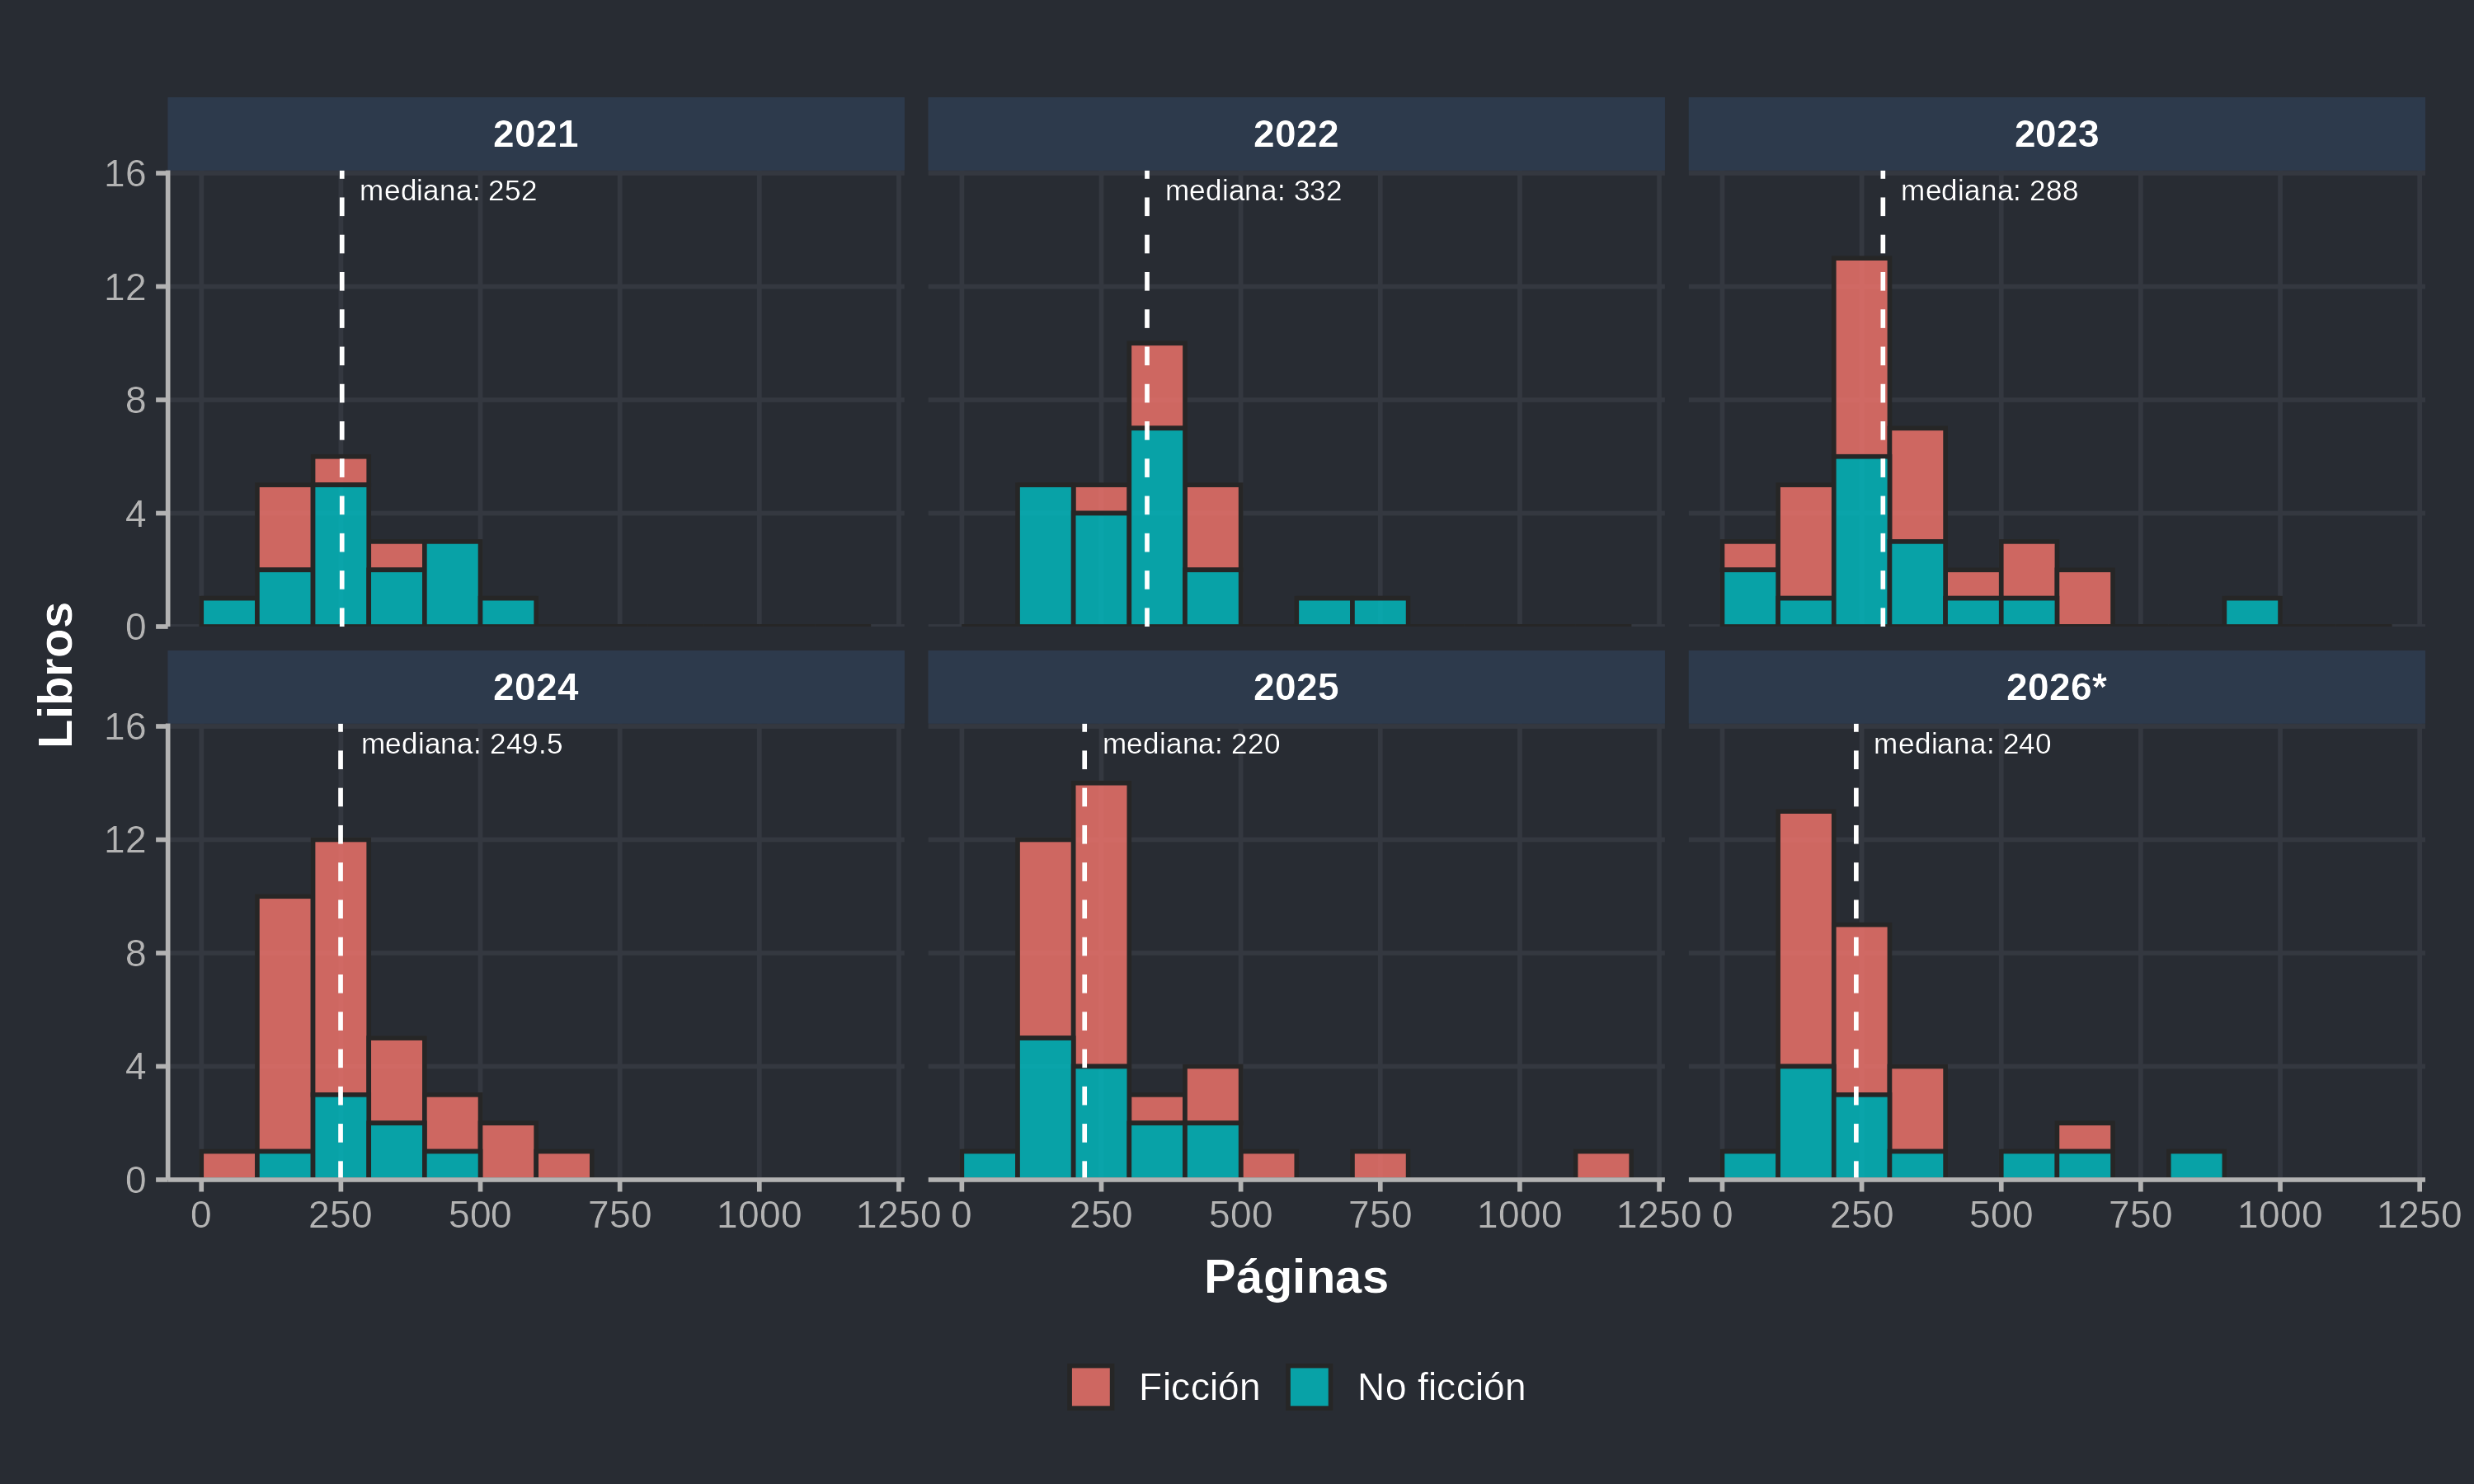
Con una línea, facet_wrap(~ Year_read), el histograma se parte en seis. La mediana de cada panel sale de un data frame aparte (medianas) que tiene la misma columna Year_read, y ggplot sabe en qué panel dibujar cada línea. Los libros se fueron acortando: de una mediana de 332 páginas en 2022 a 220 en 2025. Los ladrillos de más de 1.000 páginas son casi todos de la saga de Canción de hielo y fuego.
Otra pregunta es cuán viejos son los libros que leo. Contando por década de la publicación original:
decadas <- books %>%
  filter(!is.na(`Original Publication Year`)) %>%
  mutate(decada = floor(`Original Publication Year` / 10) * 10)

decadas %>%
  filter(decada >= 1800) %>%
  count(decada, Type) %>%
  ggplot(aes(x = decada, y = n, fill = Type)) +
  geom_col(alpha = 0.8) +
  labs(caption = paste(sum(decadas$decada < 1800), "libros anteriores a 1800 no se muestran")) +
  xlab("Década de publicación original") + ylab("Libros") +
  theme_dark_blue()
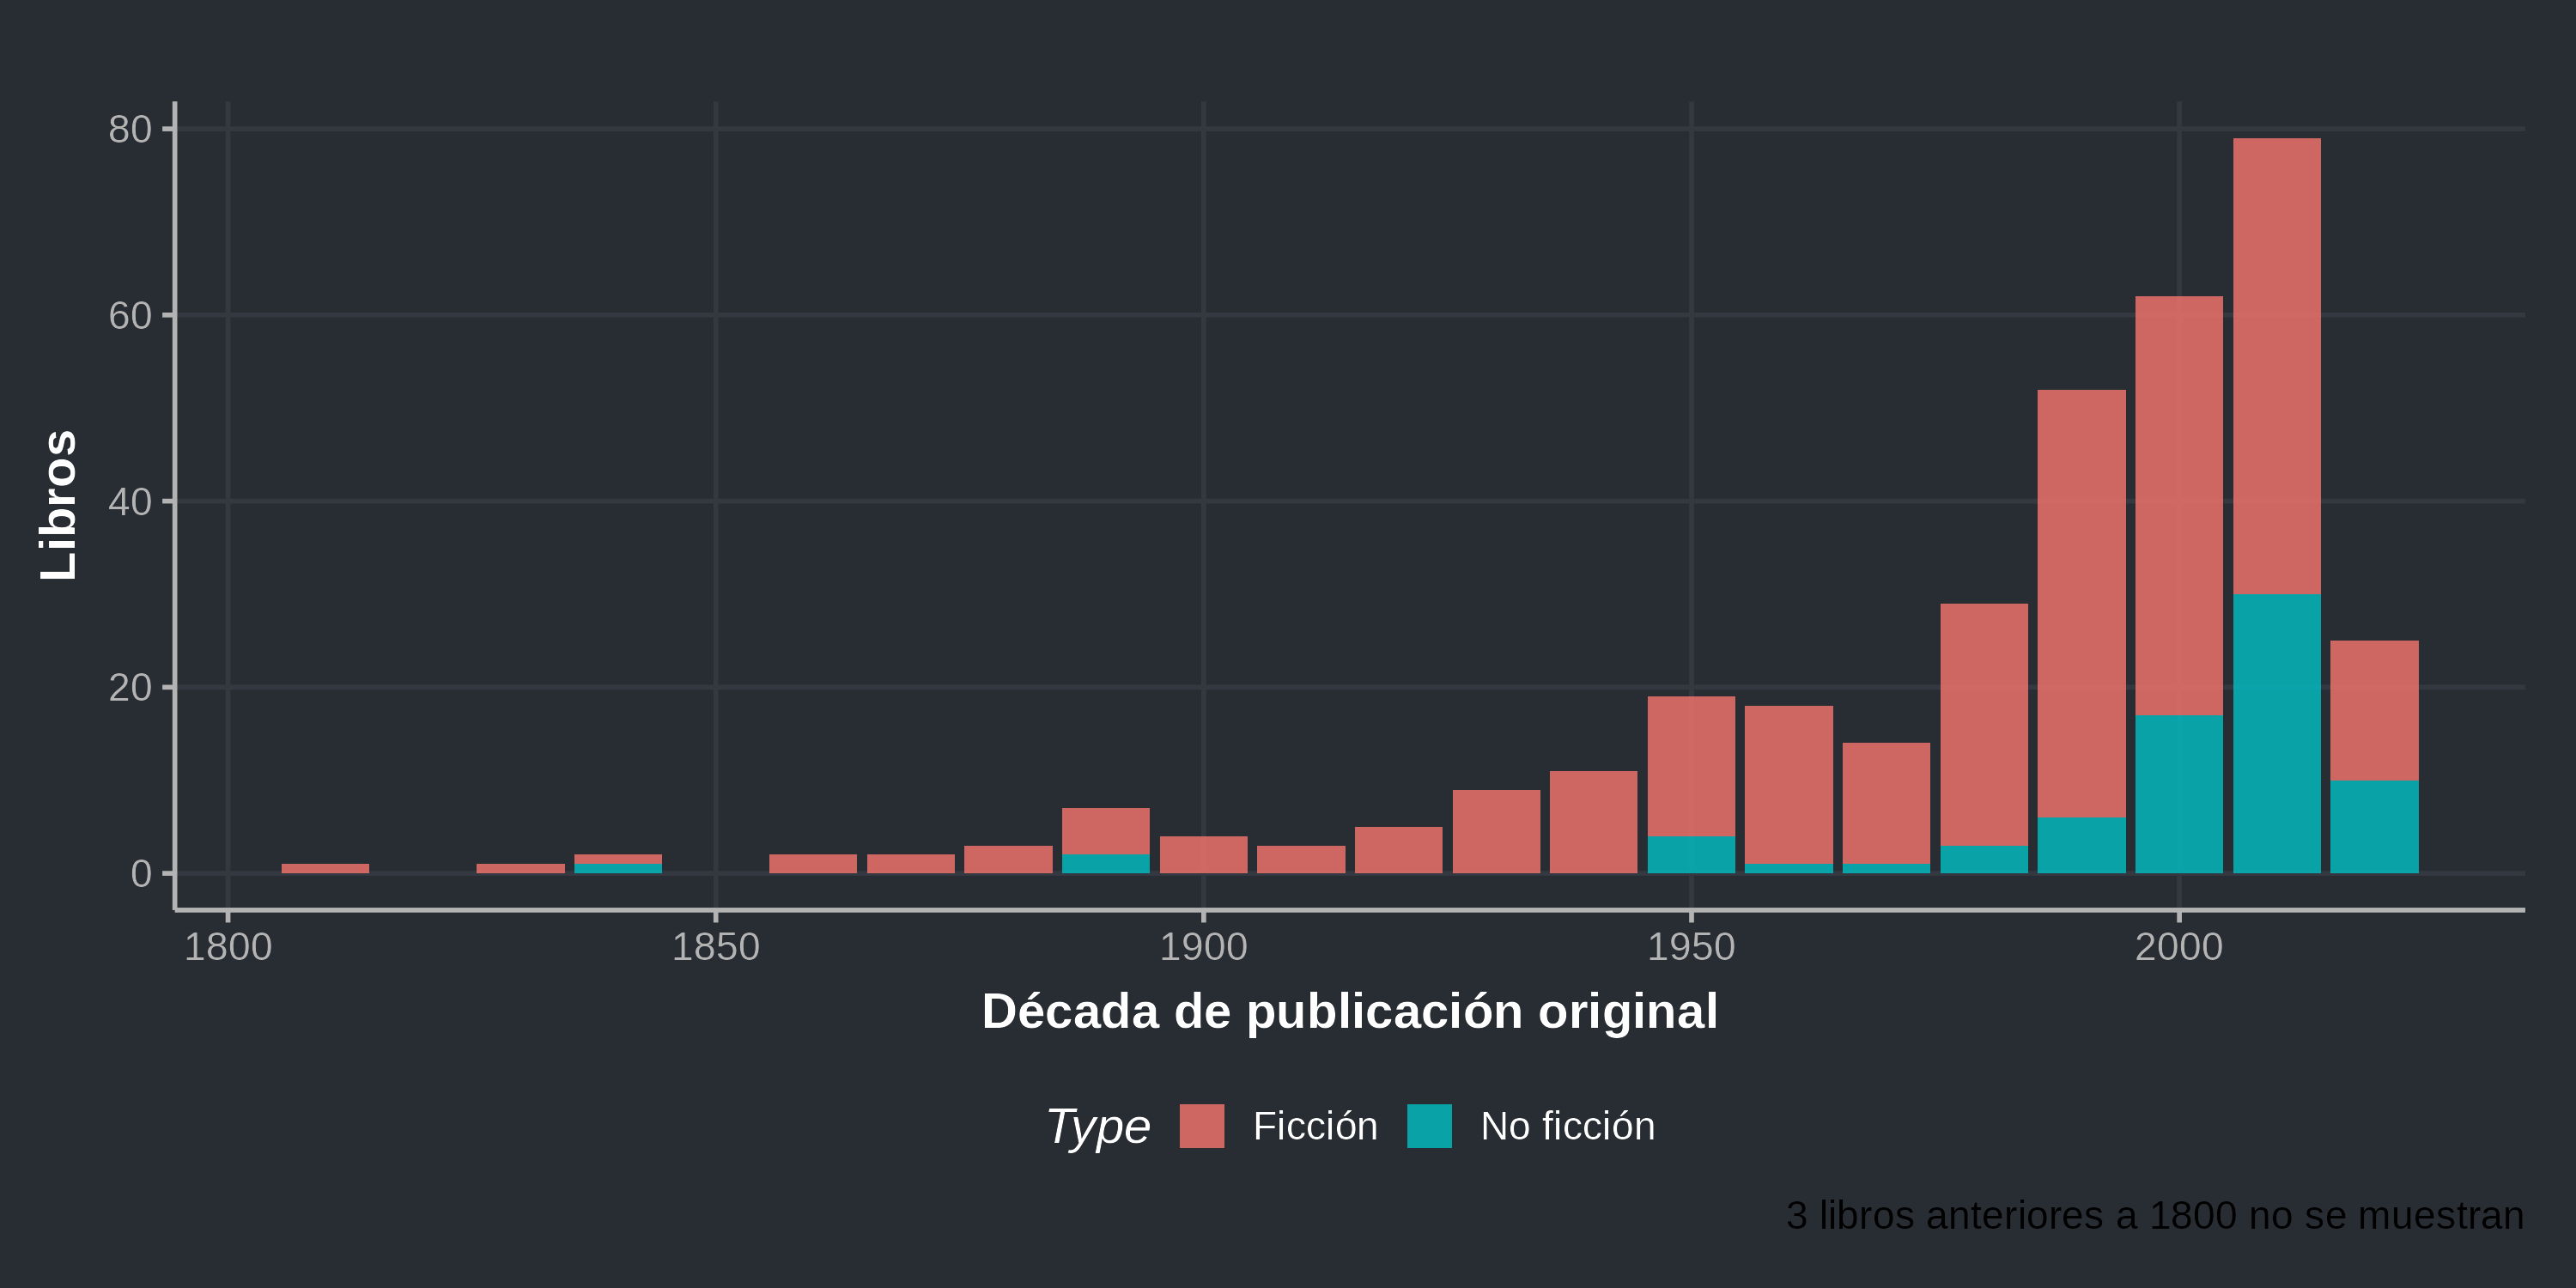
El eje empieza en 1800 porque hay tres libros mucho más antiguos (La Odisea entre ellos) que estirarían el eje dos milenios y aplastarían todo lo demás. La no ficción es casi toda de las últimas tres décadas, mientras que la ficción tiene una cola larga hacia atrás.
Para ver si eso cambia con los años, calculé cuántos años tenía cada libro al momento de leerlo y tomé la mediana por año:
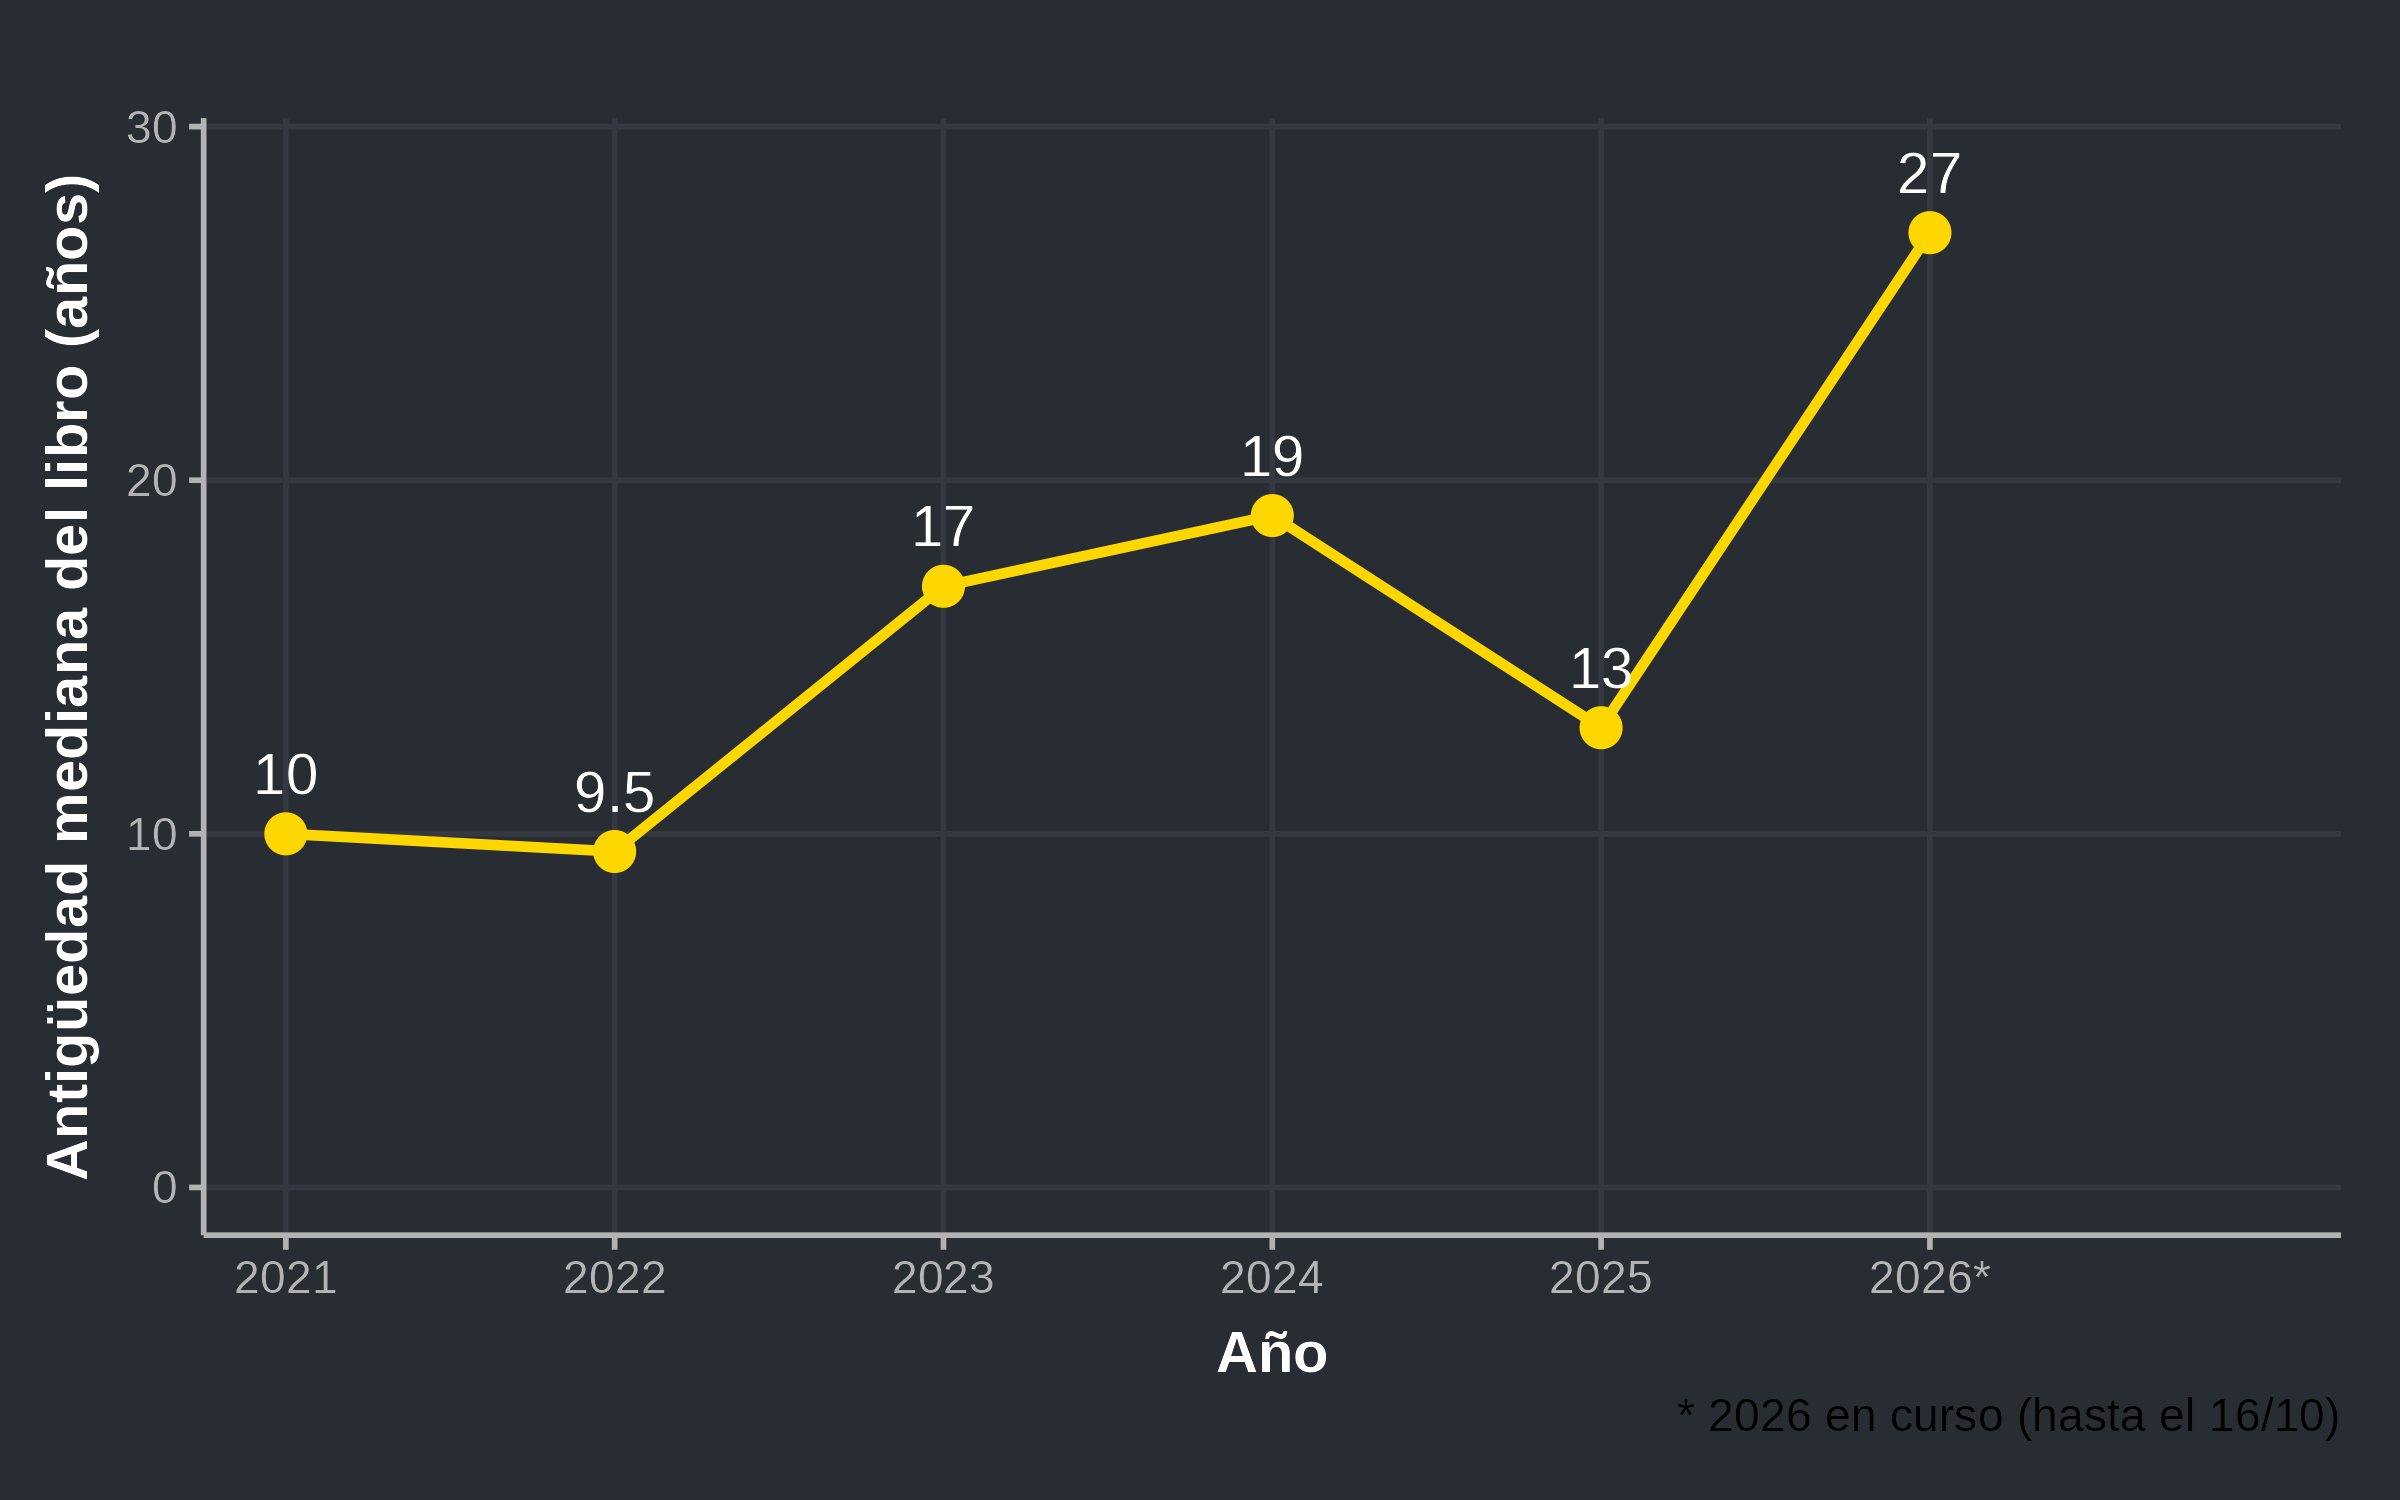
Uso la mediana y no el promedio porque los clásicos la sesgarían: un solo libro de hace 2.800 años movería el promedio de todo un año. Este 2026 viene de clásicos.
¿A quién leo?
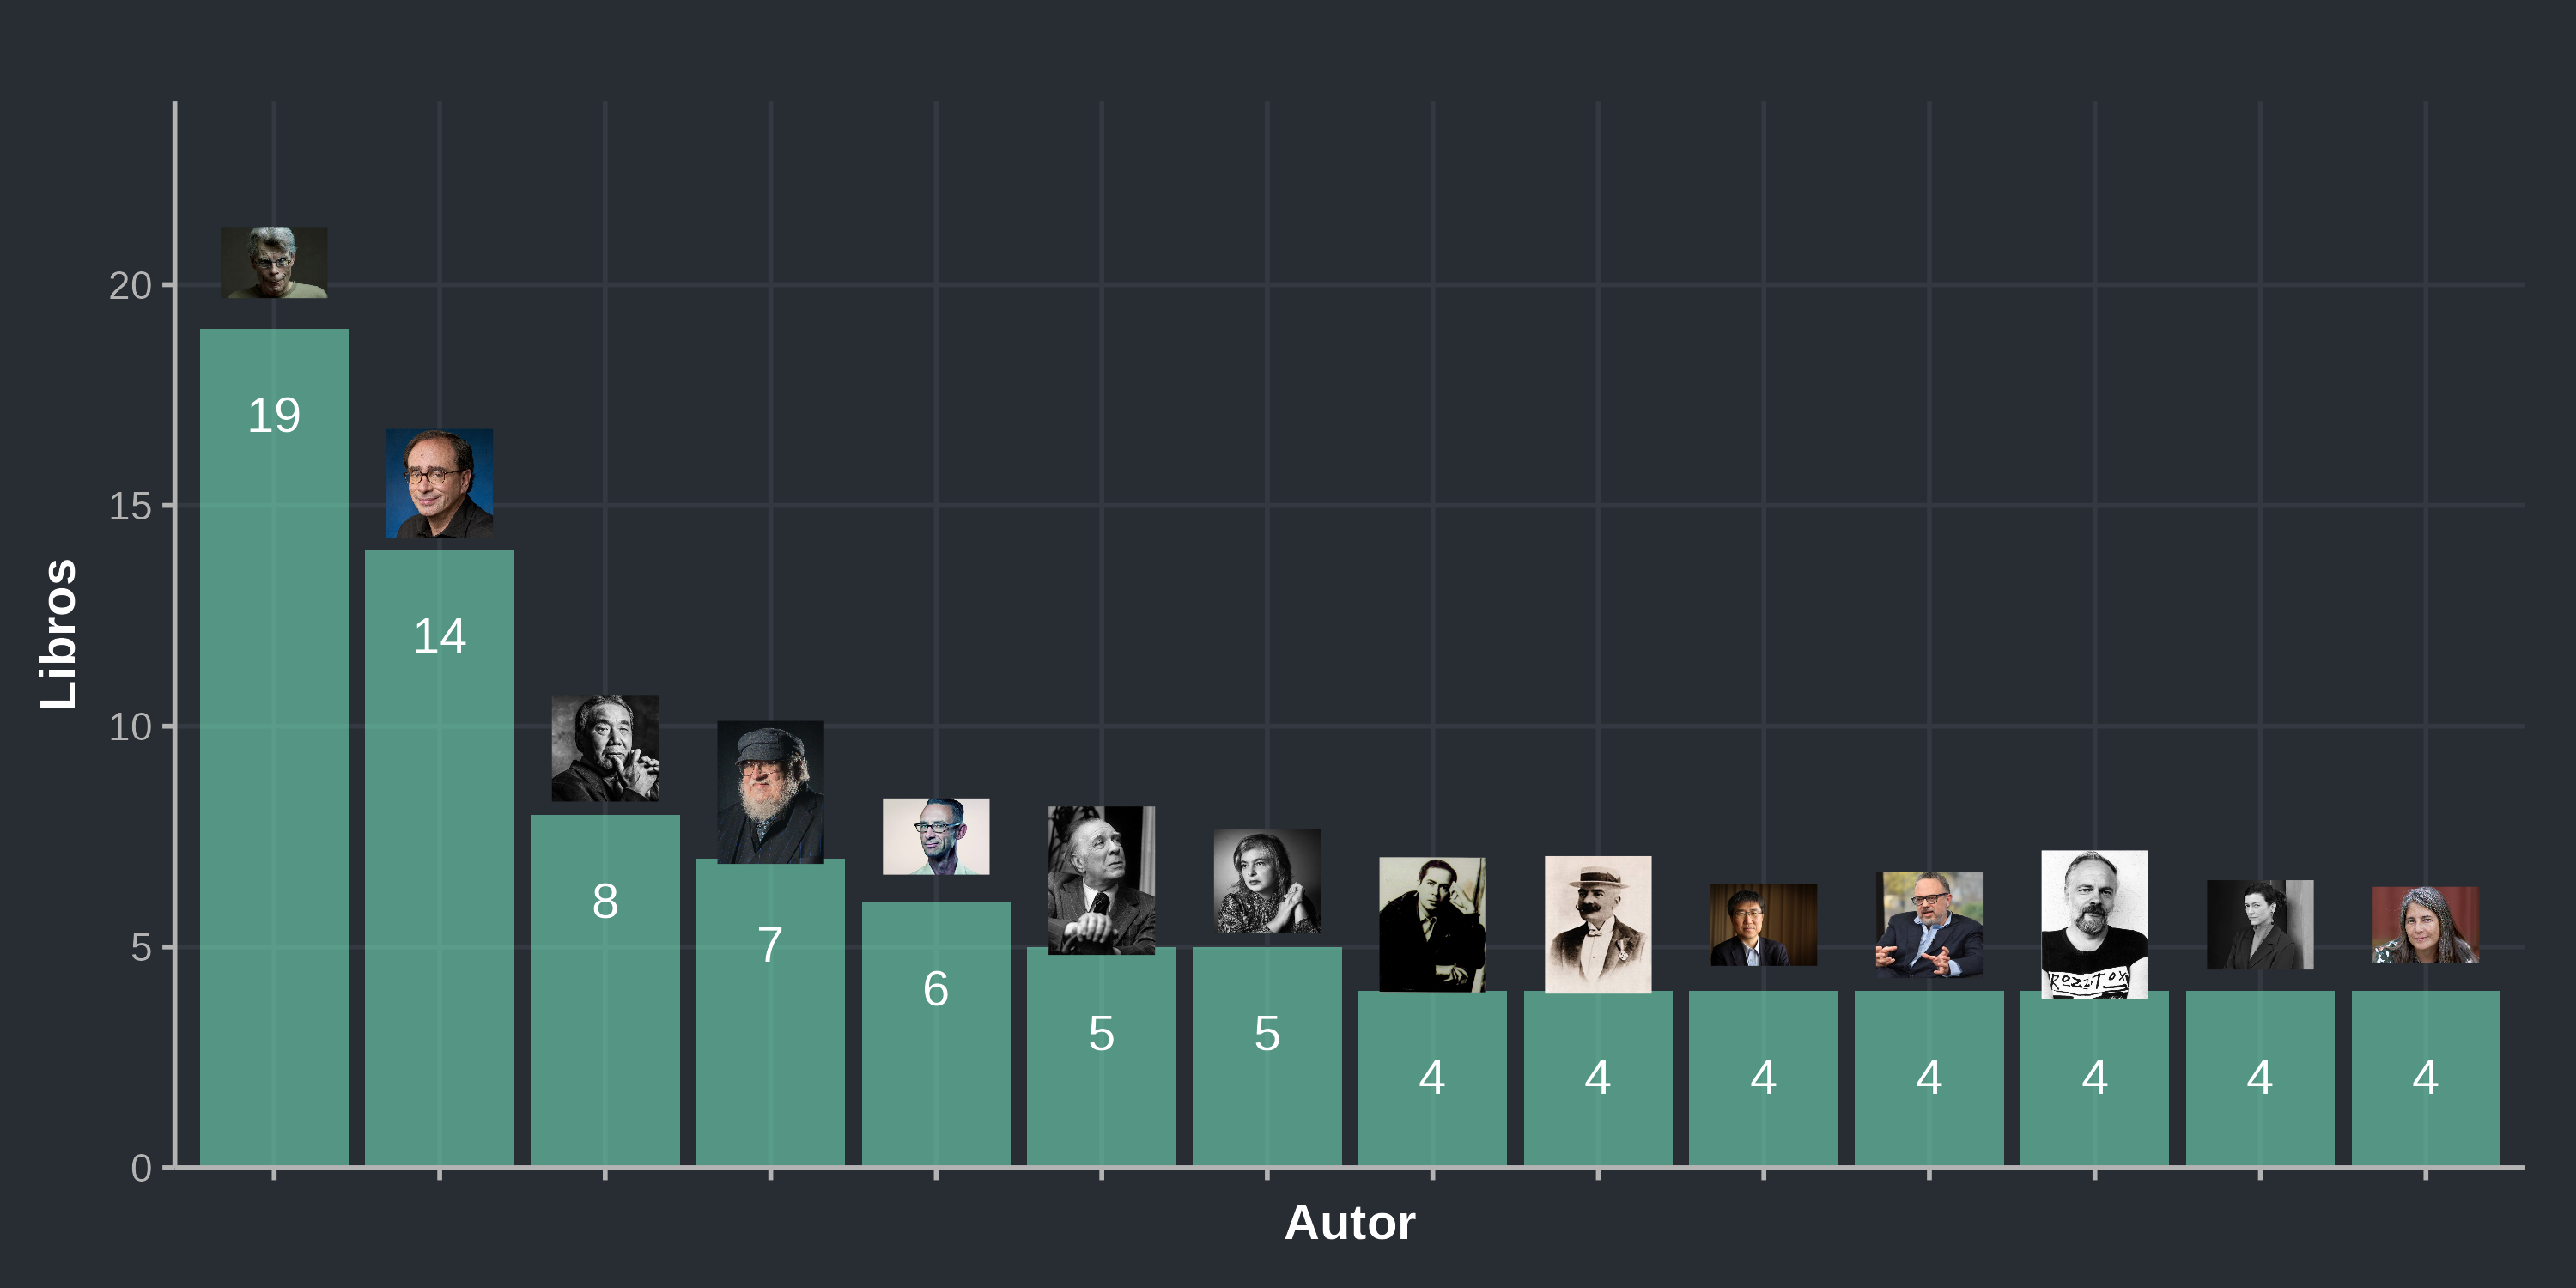
Los autores que más leí, con su foto arriba de cada barra gracias a ggimage:
authors <- books %>%
  count(Author, sort = TRUE) %>%
  filter(n >= 4) %>%
  left_join(read_csv("autores_imagenes.csv"), by = "Author")

ggplot(authors, aes(x = reorder(Author, -n), y = n)) +
  geom_col(fill = "aquamarine", alpha = 0.5) +
  geom_text(aes(label = n), vjust = 3, color = "white") +
  geom_image(aes(image = image, y = n + 1.5), size = 0.1) +
  xlab("Autor") + ylab("Libros") +
  scale_y_continuous(expand = expansion(mult = c(0, 0.05))) +
  theme_dark_blue() +
  theme(axis.text.x = element_blank())
¿De dónde son esos autores? En DataViz II vimos el treemap. Acá le agregué un nivel: los países se agrupan por continente, cada continente tiene un color y los países van del tono pleno (el más leído) a tonos más claros. El continente sale de countrycode, a partir del nombre del país en español:
nombres_es <- countrycode::codelist %>%
  select(Country = cldr.name.es, iso3 = iso3c) %>%
  filter(!is.na(Country), !is.na(iso3))

country <- books %>%
  count(Country, sort = TRUE) %>%
  left_join(nombres_es, by = "Country") %>%
  mutate(
    continente = countrycode(iso3, "iso3c", "continent", warn = FALSE),
    region     = countrycode(iso3, "iso3c", "region", warn = FALSE),
    continente = case_when(
      continente == "Americas" & region == "North America" ~ "Norteamérica",
      continente == "Americas"                             ~ "Latinoamérica",
      is.na(continente)                                    ~ "Otro",
      TRUE                                                 ~ unname(continente_es[continente])
    )
  )

# Un color base por continente, aclarándose según el ranking del país
country <- country %>%
  group_by(continente) %>%
  arrange(desc(n), .by_group = TRUE) %>%
  mutate(color = colorRampPalette(c(colores_base[[first(continente)]], "white"))(
    round(n() * 1.8) + 1)[row_number()]) %>%
  ungroup()

ggplot(country, aes(area = n, fill = color, subgroup = continente,
                    label = paste0(Country, "\n", n))) +
  geom_treemap(colour = "white") +
  geom_treemap_subgroup_border(colour = "white", size = 4) +
  geom_treemap_text(colour = "grey15", place = "centre", grow = TRUE,
                    reflow = TRUE, min.size = 3) +
  geom_treemap_subgroup_text(colour = "grey10", place = "topleft", grow = FALSE,
                             size = 14, fontface = "bold", alpha = 0.6) +
  scale_fill_identity() +
  theme_void()
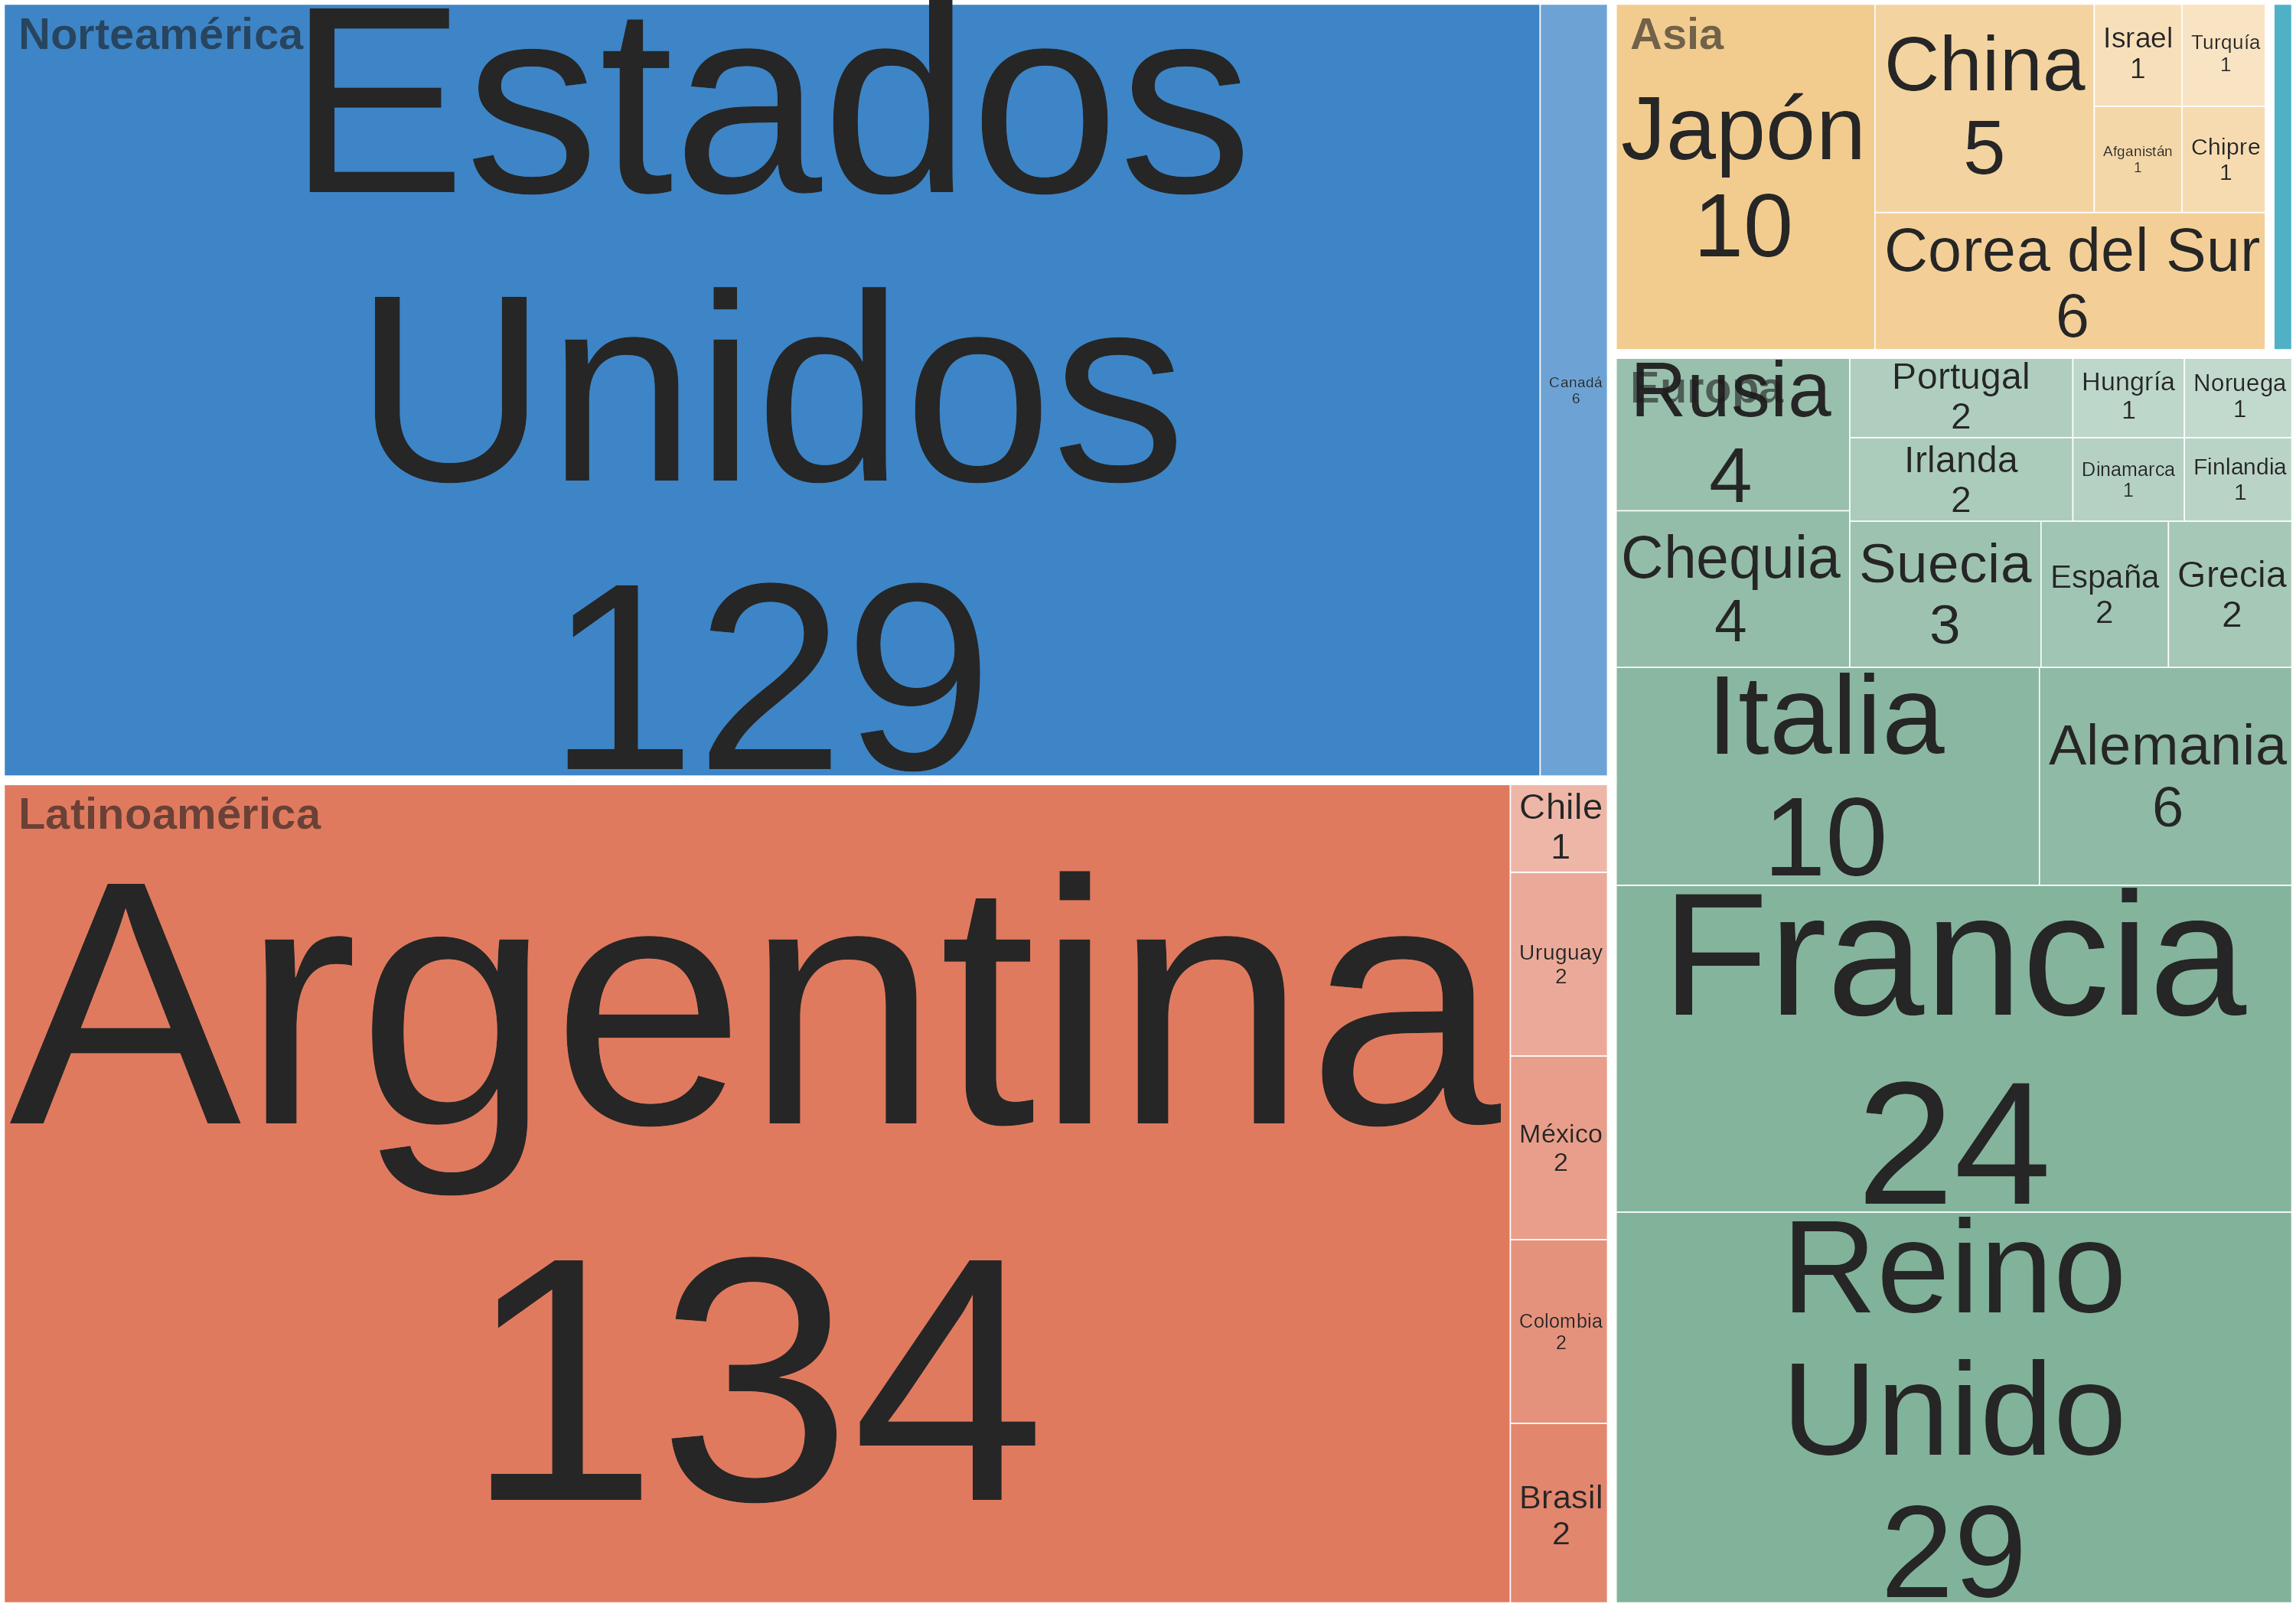
Argentina y Estados Unidos se reparten dos tercios de la biblioteca. Eso es lo que muestra el treemap, que es bueno para comparar tamaños. Para ver la geografía, en cambio, nada como un mapa. Con sf y rnaturalearth es casi gratis una vez que tenemos los códigos ISO:
world <- rnaturalearth::ne_countries(scale = "small", returnclass = "sf") %>%
  left_join(country %>% filter(!is.na(iso3)) %>% select(iso3, n),
            by = c("adm0_a3" = "iso3"))

ggplot(world) +
  geom_sf(aes(fill = n), color = "grey40", linewidth = 0.1) +
  scale_fill_viridis_c(trans = "log10", na.value = "grey85", direction = -1, name = "Libros") +
  coord_sf(crs = "+proj=robin") +
  theme_void()
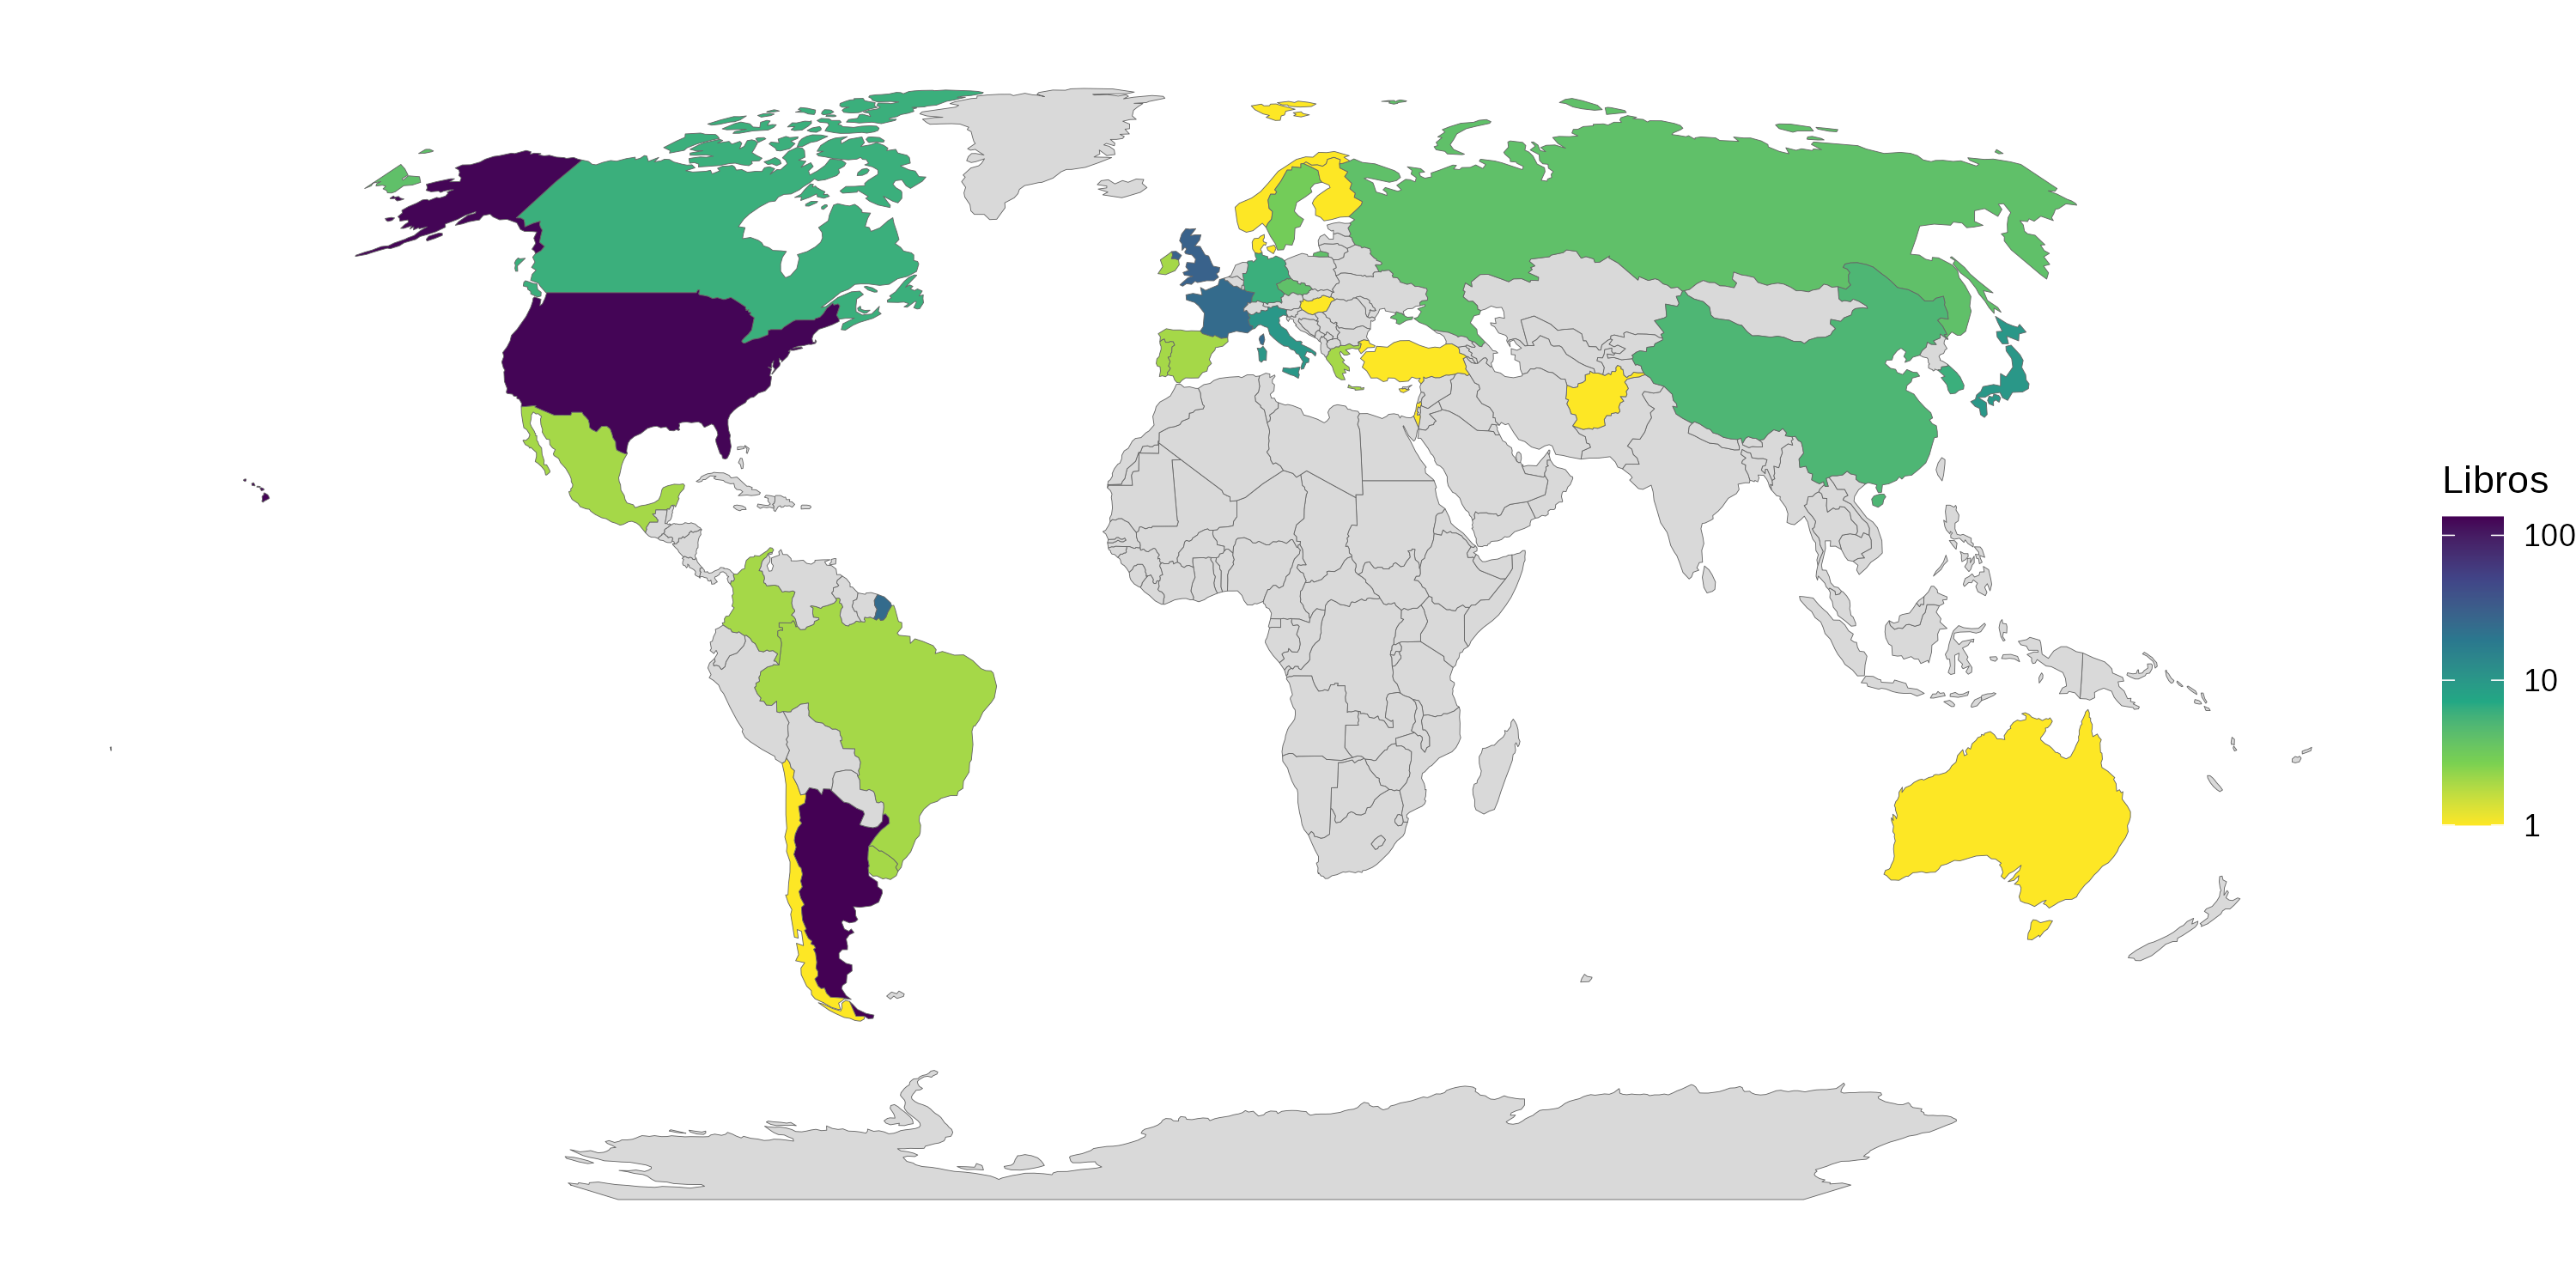
El mapa deja a la vista la gran deuda: África, de donde no leí ningún libro.
Con el idioma la historia es más simple: leo el 83% en español y el resto en inglés. Y por género del autor:
gender_year <- books_recent %>%
  count(Year_read, Gender) %>%
  complete(Year_read, Gender, fill = list(n = 0)) %>%
  group_by(Year_read) %>%
  mutate(total = sum(n), pct = 100 * n / total) %>%
  ungroup() %>%
  filter(Gender == "Mujer")

ggplot(gender_year, aes(x = Year_read, y = pct)) +
  geom_line(color = "orchid", linewidth = 1.2) +
  geom_point(color = "orchid", size = 4) +
  geom_text(aes(label = paste0(round(pct), "%\n(", n, "/", total, ")")),
            vjust = -0.5, color = "white", size = 3.5) +
  capa_anios +
  scale_y_continuous(limits = c(0, 100), labels = function(x) paste0(x, "%")) +
  xlab("Año") + ylab("Libros escritos por mujeres") +
  theme_dark_blue()
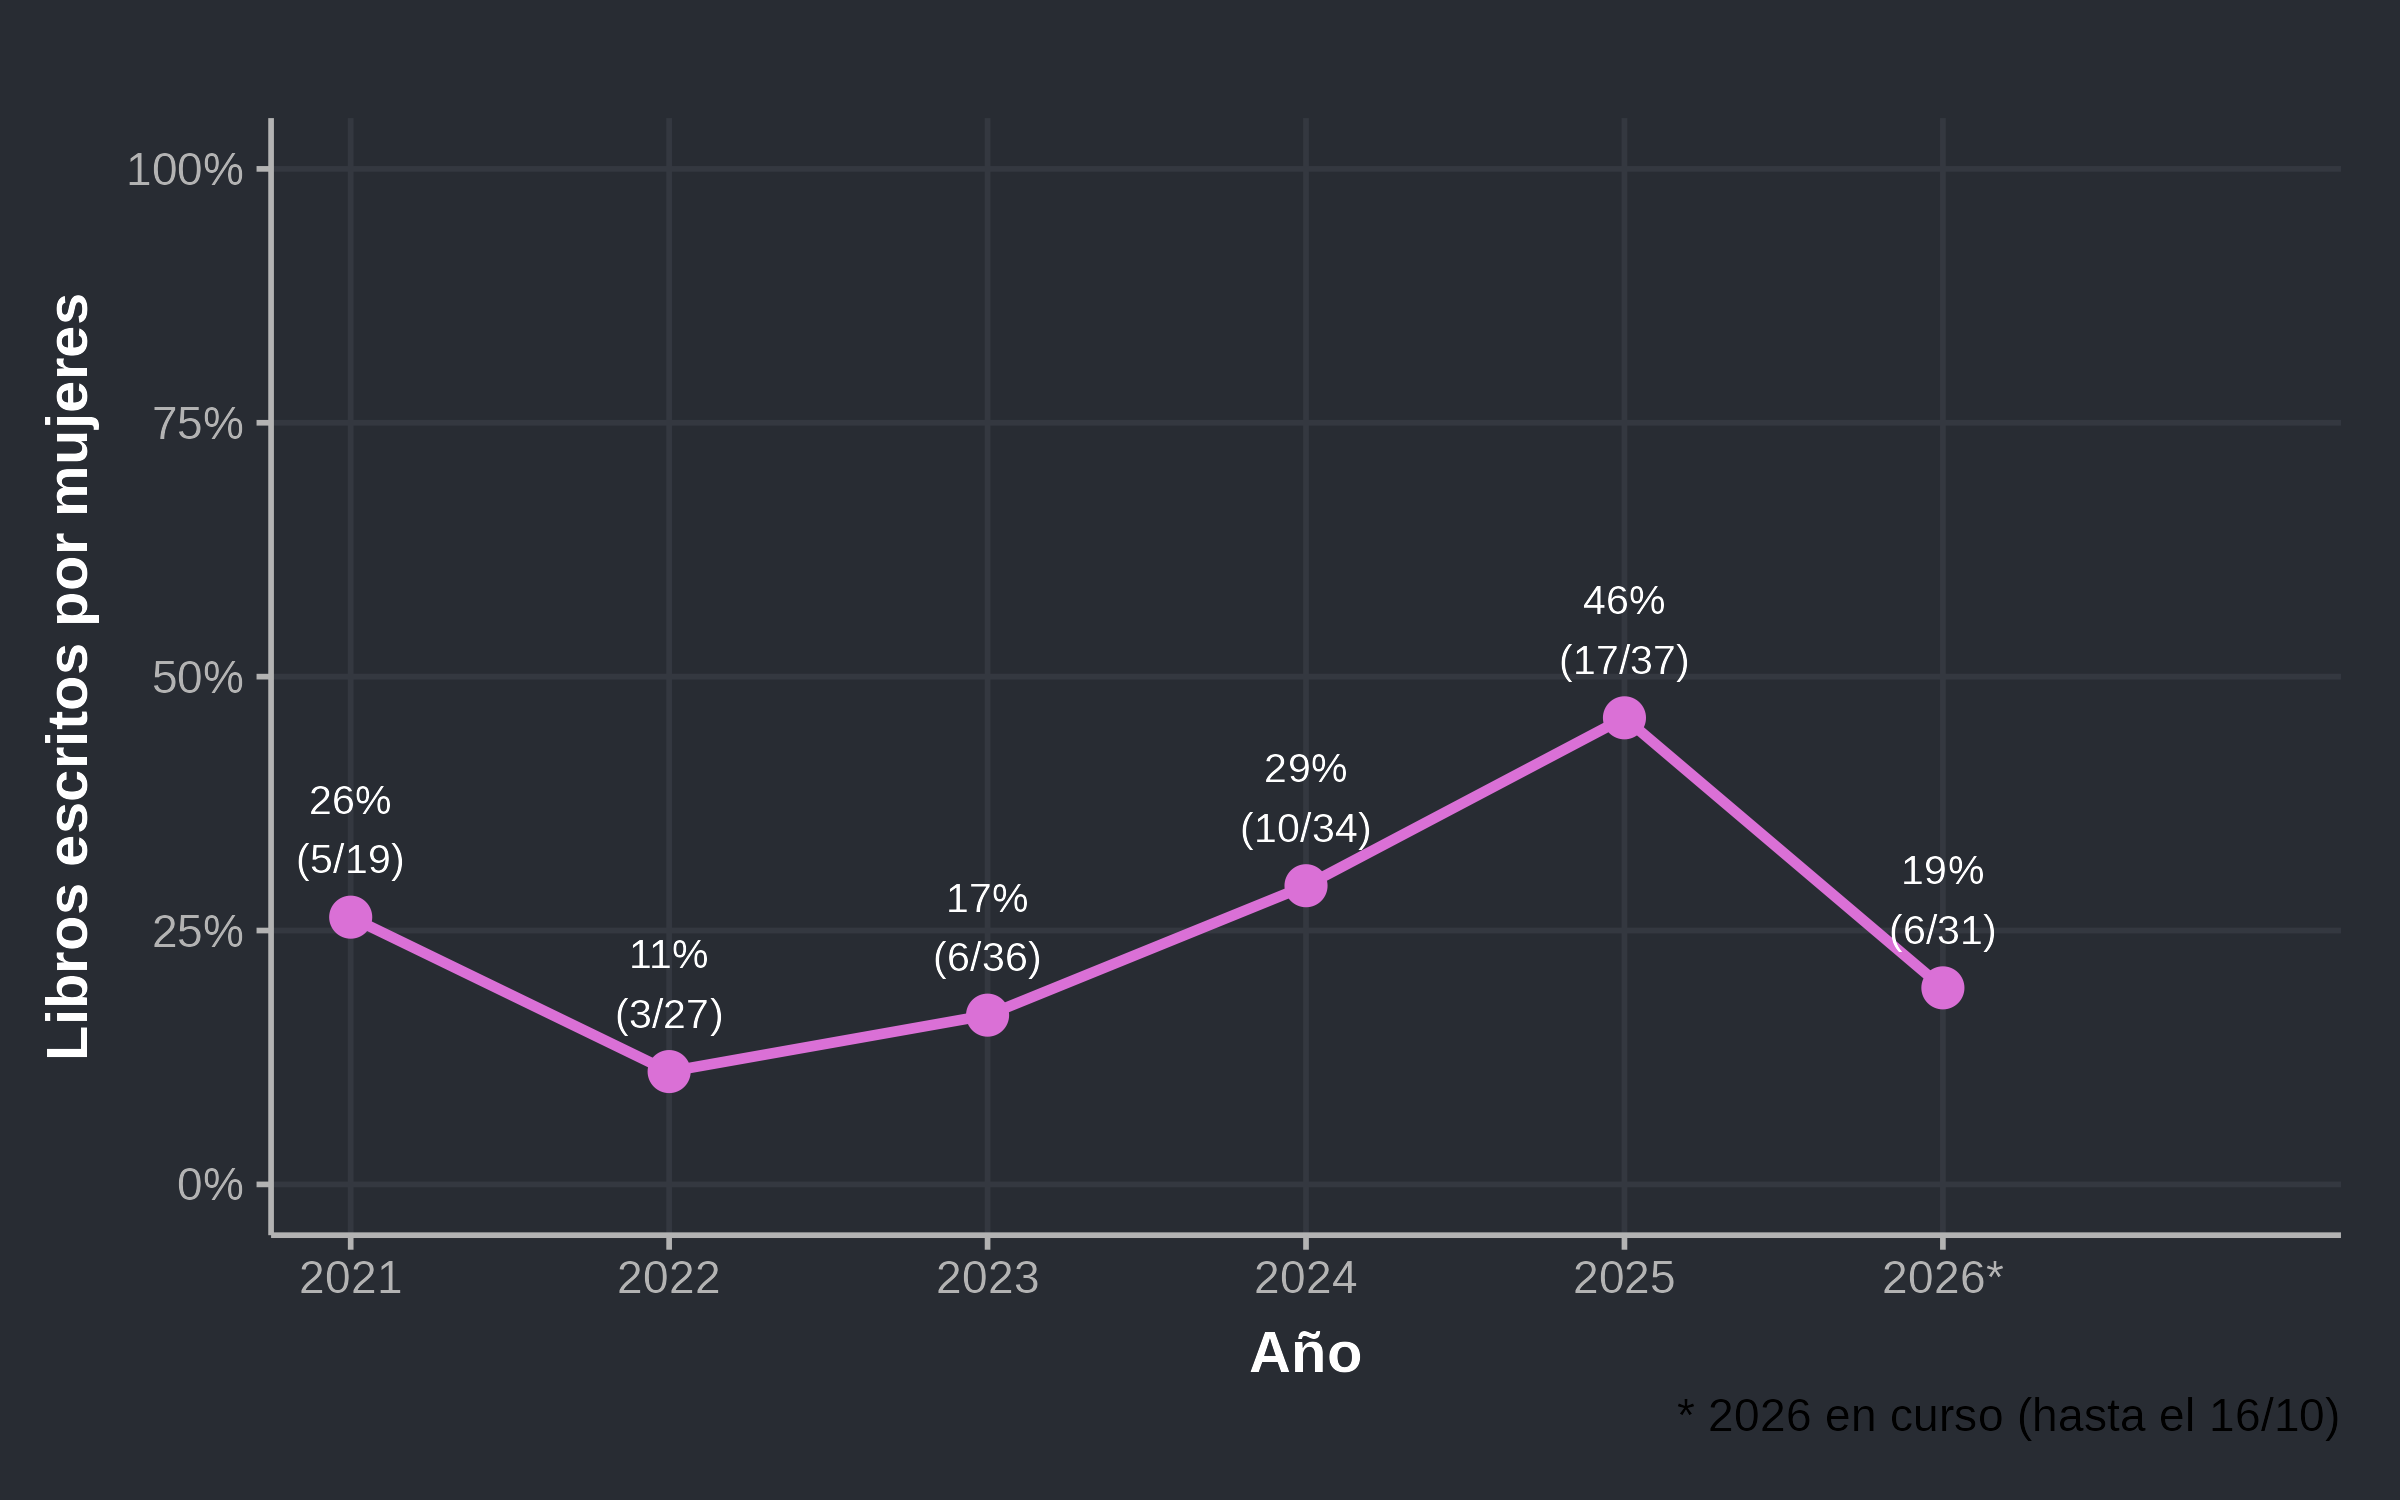
En el total, solo el 16% de los libros que leí son de autoras. La etiqueta del gráfico muestra el porcentaje y el conteo entre paréntesis. 2025 fue el año más parejo.
¿Qué me gusta?
Goodreads guarda dos ratings por libro: el mío y el promedio de todos los usuarios. Lo natural es enfrentarlos en un scatter, con la línea y = x como referencia: arriba de la línea están los libros que me gustaron más que al resto, y abajo los que me gustaron menos.
ratings <- books %>%
  filter(!is.na(`My Rating`), !is.na(`Average Rating`)) %>%
  mutate(dif = `My Rating` - `Average Rating`)

# Los 5 libros que más sobrevaloré y los 5 que más subvaloré
extremos <- bind_rows(slice_max(ratings, dif, n = 5, with_ties = FALSE),
                      slice_min(ratings, dif, n = 5, with_ties = FALSE))

ggplot(ratings, aes(x = `Average Rating`, y = `My Rating`)) +
  geom_abline(slope = 1, intercept = 0, linetype = "dashed", color = "grey70") +
  geom_jitter(aes(color = Type), height = 0.15, width = 0, alpha = 0.6, size = 2) +
  geom_text_repel(data = extremos, aes(label = str_trunc(Title, 30)),
                  color = "white", size = 3, max.overlaps = Inf) +
  xlab("Rating promedio en Goodreads") + ylab("Mi rating") +
  theme_dark_blue()
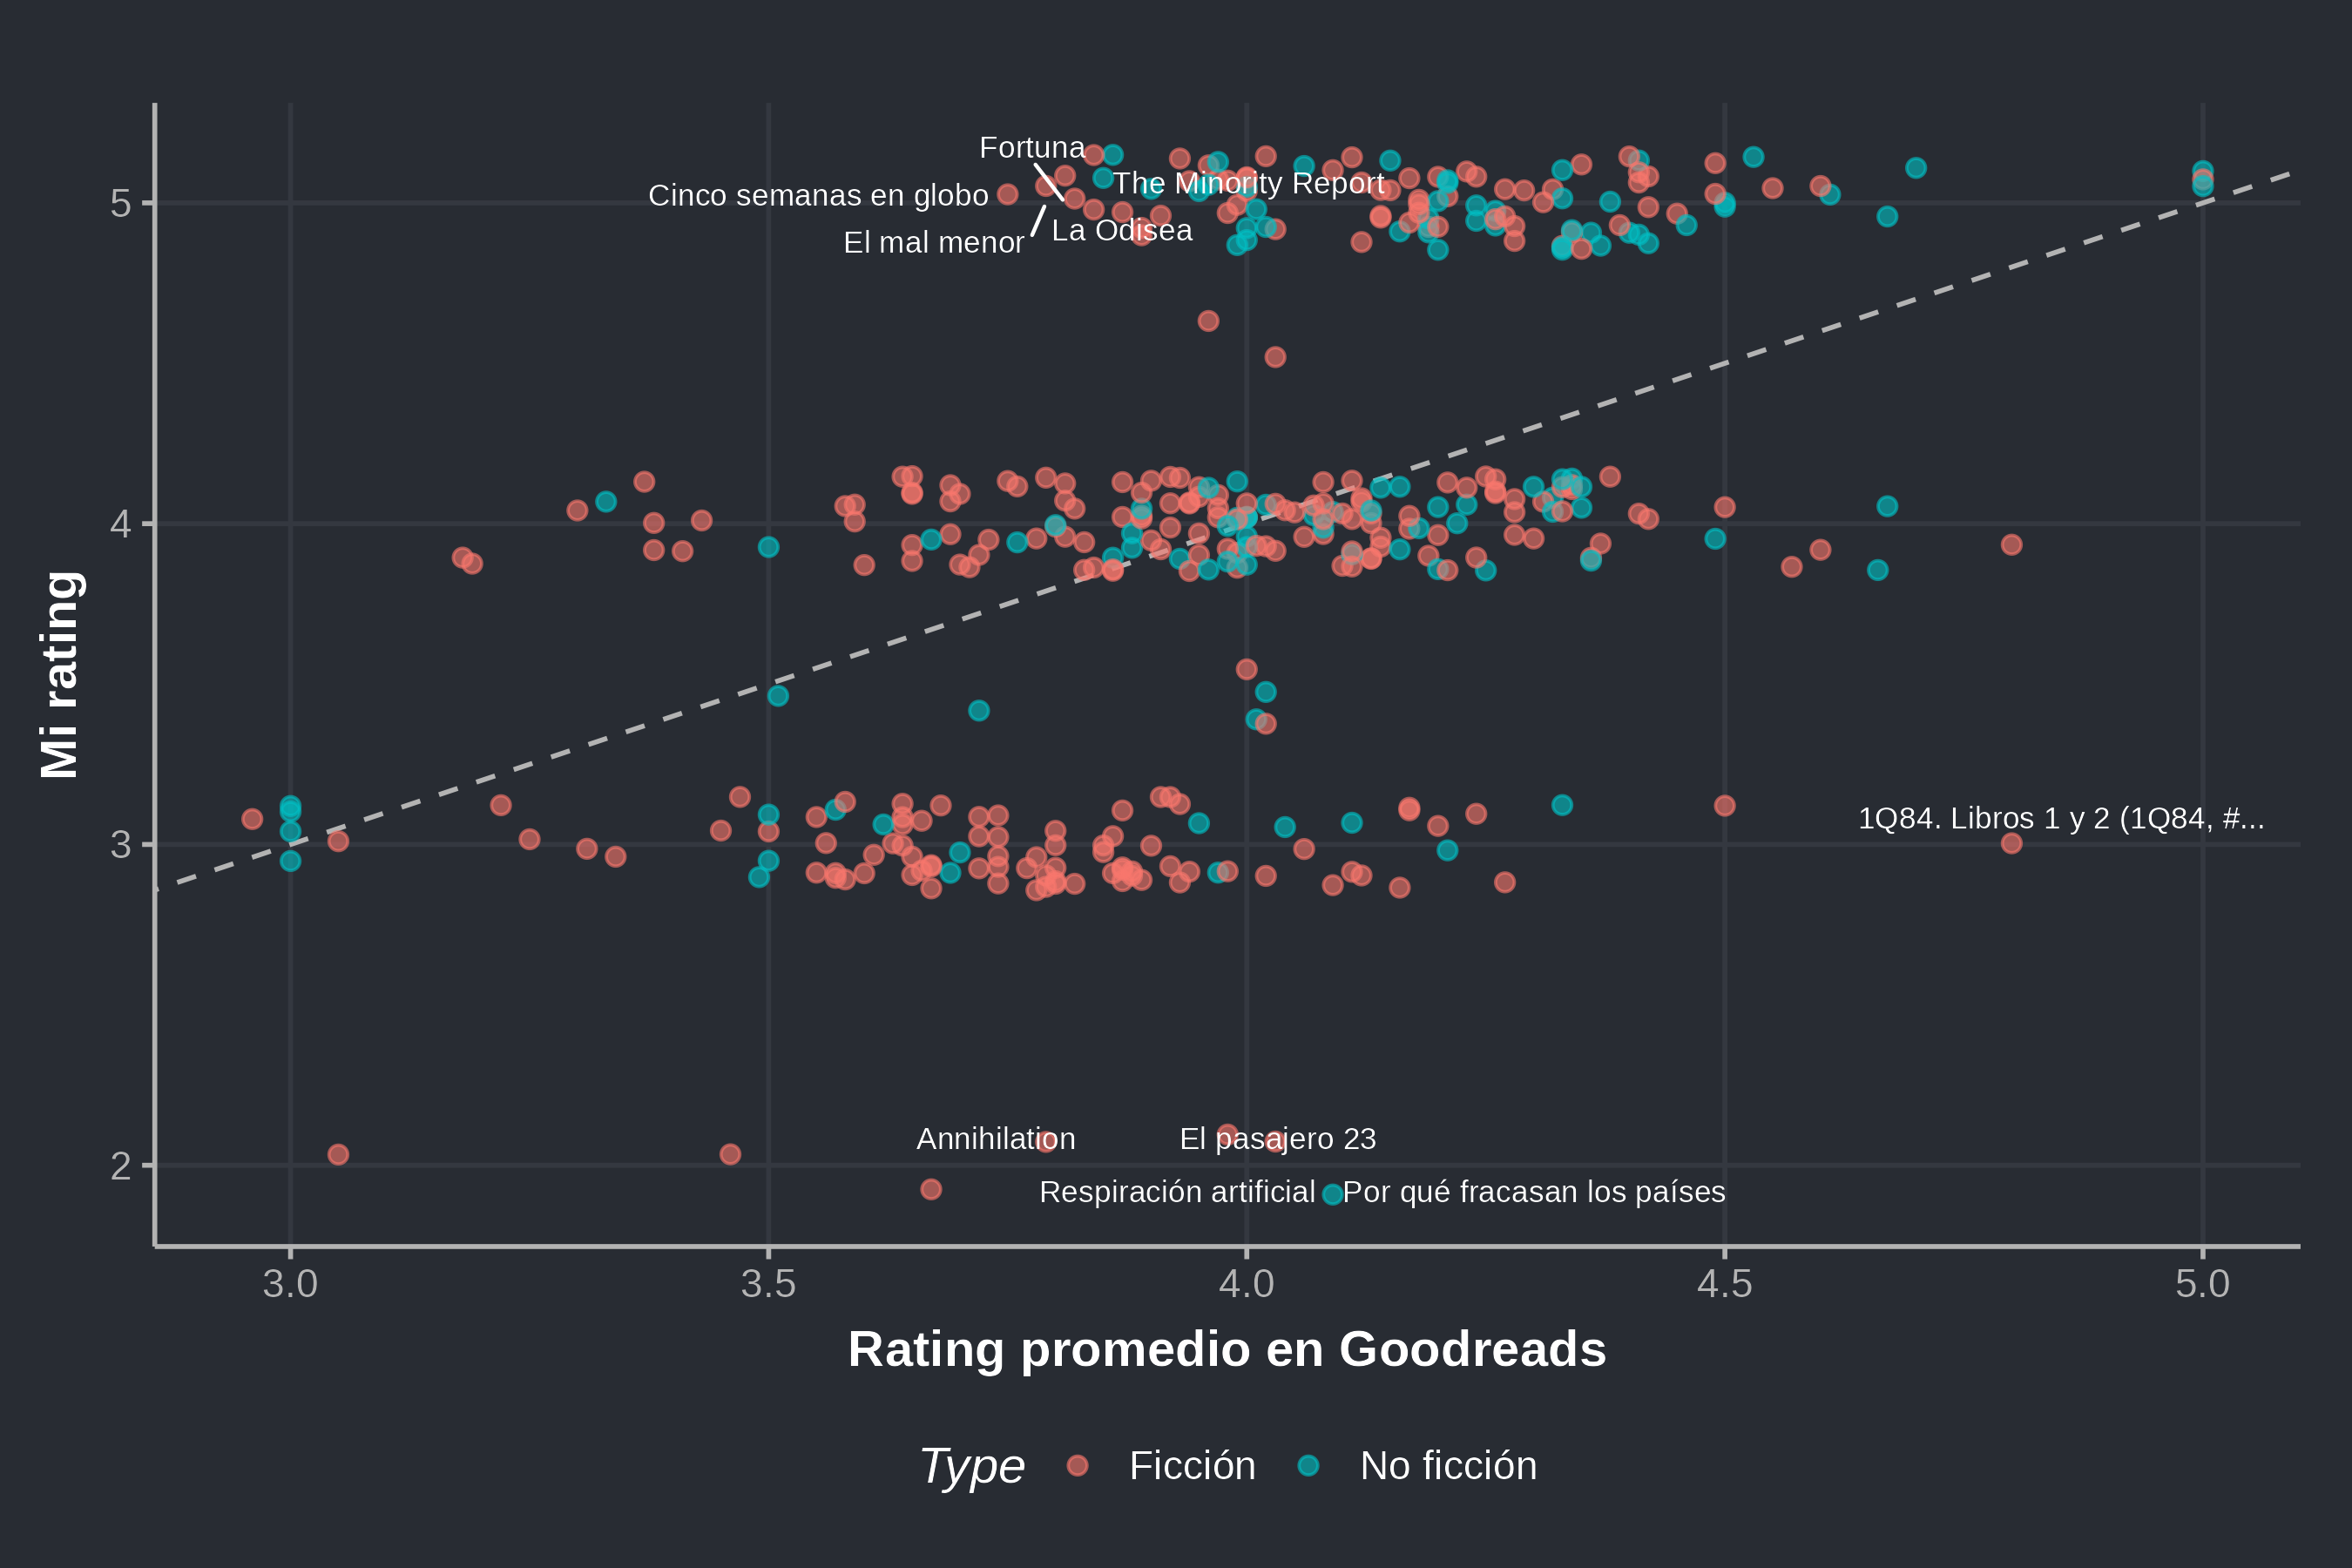
Entre los que puse mucho más alto que el promedio hay clásicos como La Odisea o Cinco semanas en globo. Entre los que puntué muy por debajo del promedio están Annihilation y Por qué fracasan los países.
El scatter muestra libro por libro. Para comparar por autor, una buena opción es el dumbbell plot (o gráfico de pesas): dos puntos por autor, uno para cada rating, unidos por un segmento.
dumbbell <- ratings %>%
  group_by(Author) %>%
  filter(n() >= 3) %>%
  summarize(mio = mean(`My Rating`), goodreads = mean(`Average Rating`), n = n()) %>%
  mutate(Author = fct_reorder(Author, mio - goodreads))

# Fila de arriba, para rotular los puntos una sola vez en lugar de usar leyenda
fila_top <- ~ filter(.x, Author == last(levels(Author)))

ggplot(dumbbell, aes(y = Author)) +
  geom_segment(aes(x = goodreads, xend = mio, yend = Author),
               color = "grey60", linewidth = 1.2) +
  geom_point(aes(x = goodreads), color = "grey70", size = 4) +
  geom_point(aes(x = mio, color = mio > goodreads), size = 4) +
  geom_text(data = fila_top, aes(x = goodreads, label = "Goodreads"),
            vjust = -1.3, size = 3.5, color = "grey70") +
  geom_text(data = fila_top, aes(x = mio, label = "Yo"),
            vjust = -1.3, size = 3.5, color = "white") +
  scale_color_manual(values = c(`TRUE` = "aquamarine", `FALSE` = "salmon"), guide = "none") +
  scale_y_discrete(expand = expansion(add = c(0.6, 1.2))) +
  xlab("Rating promedio") + ylab("") +
  theme_dark_blue()
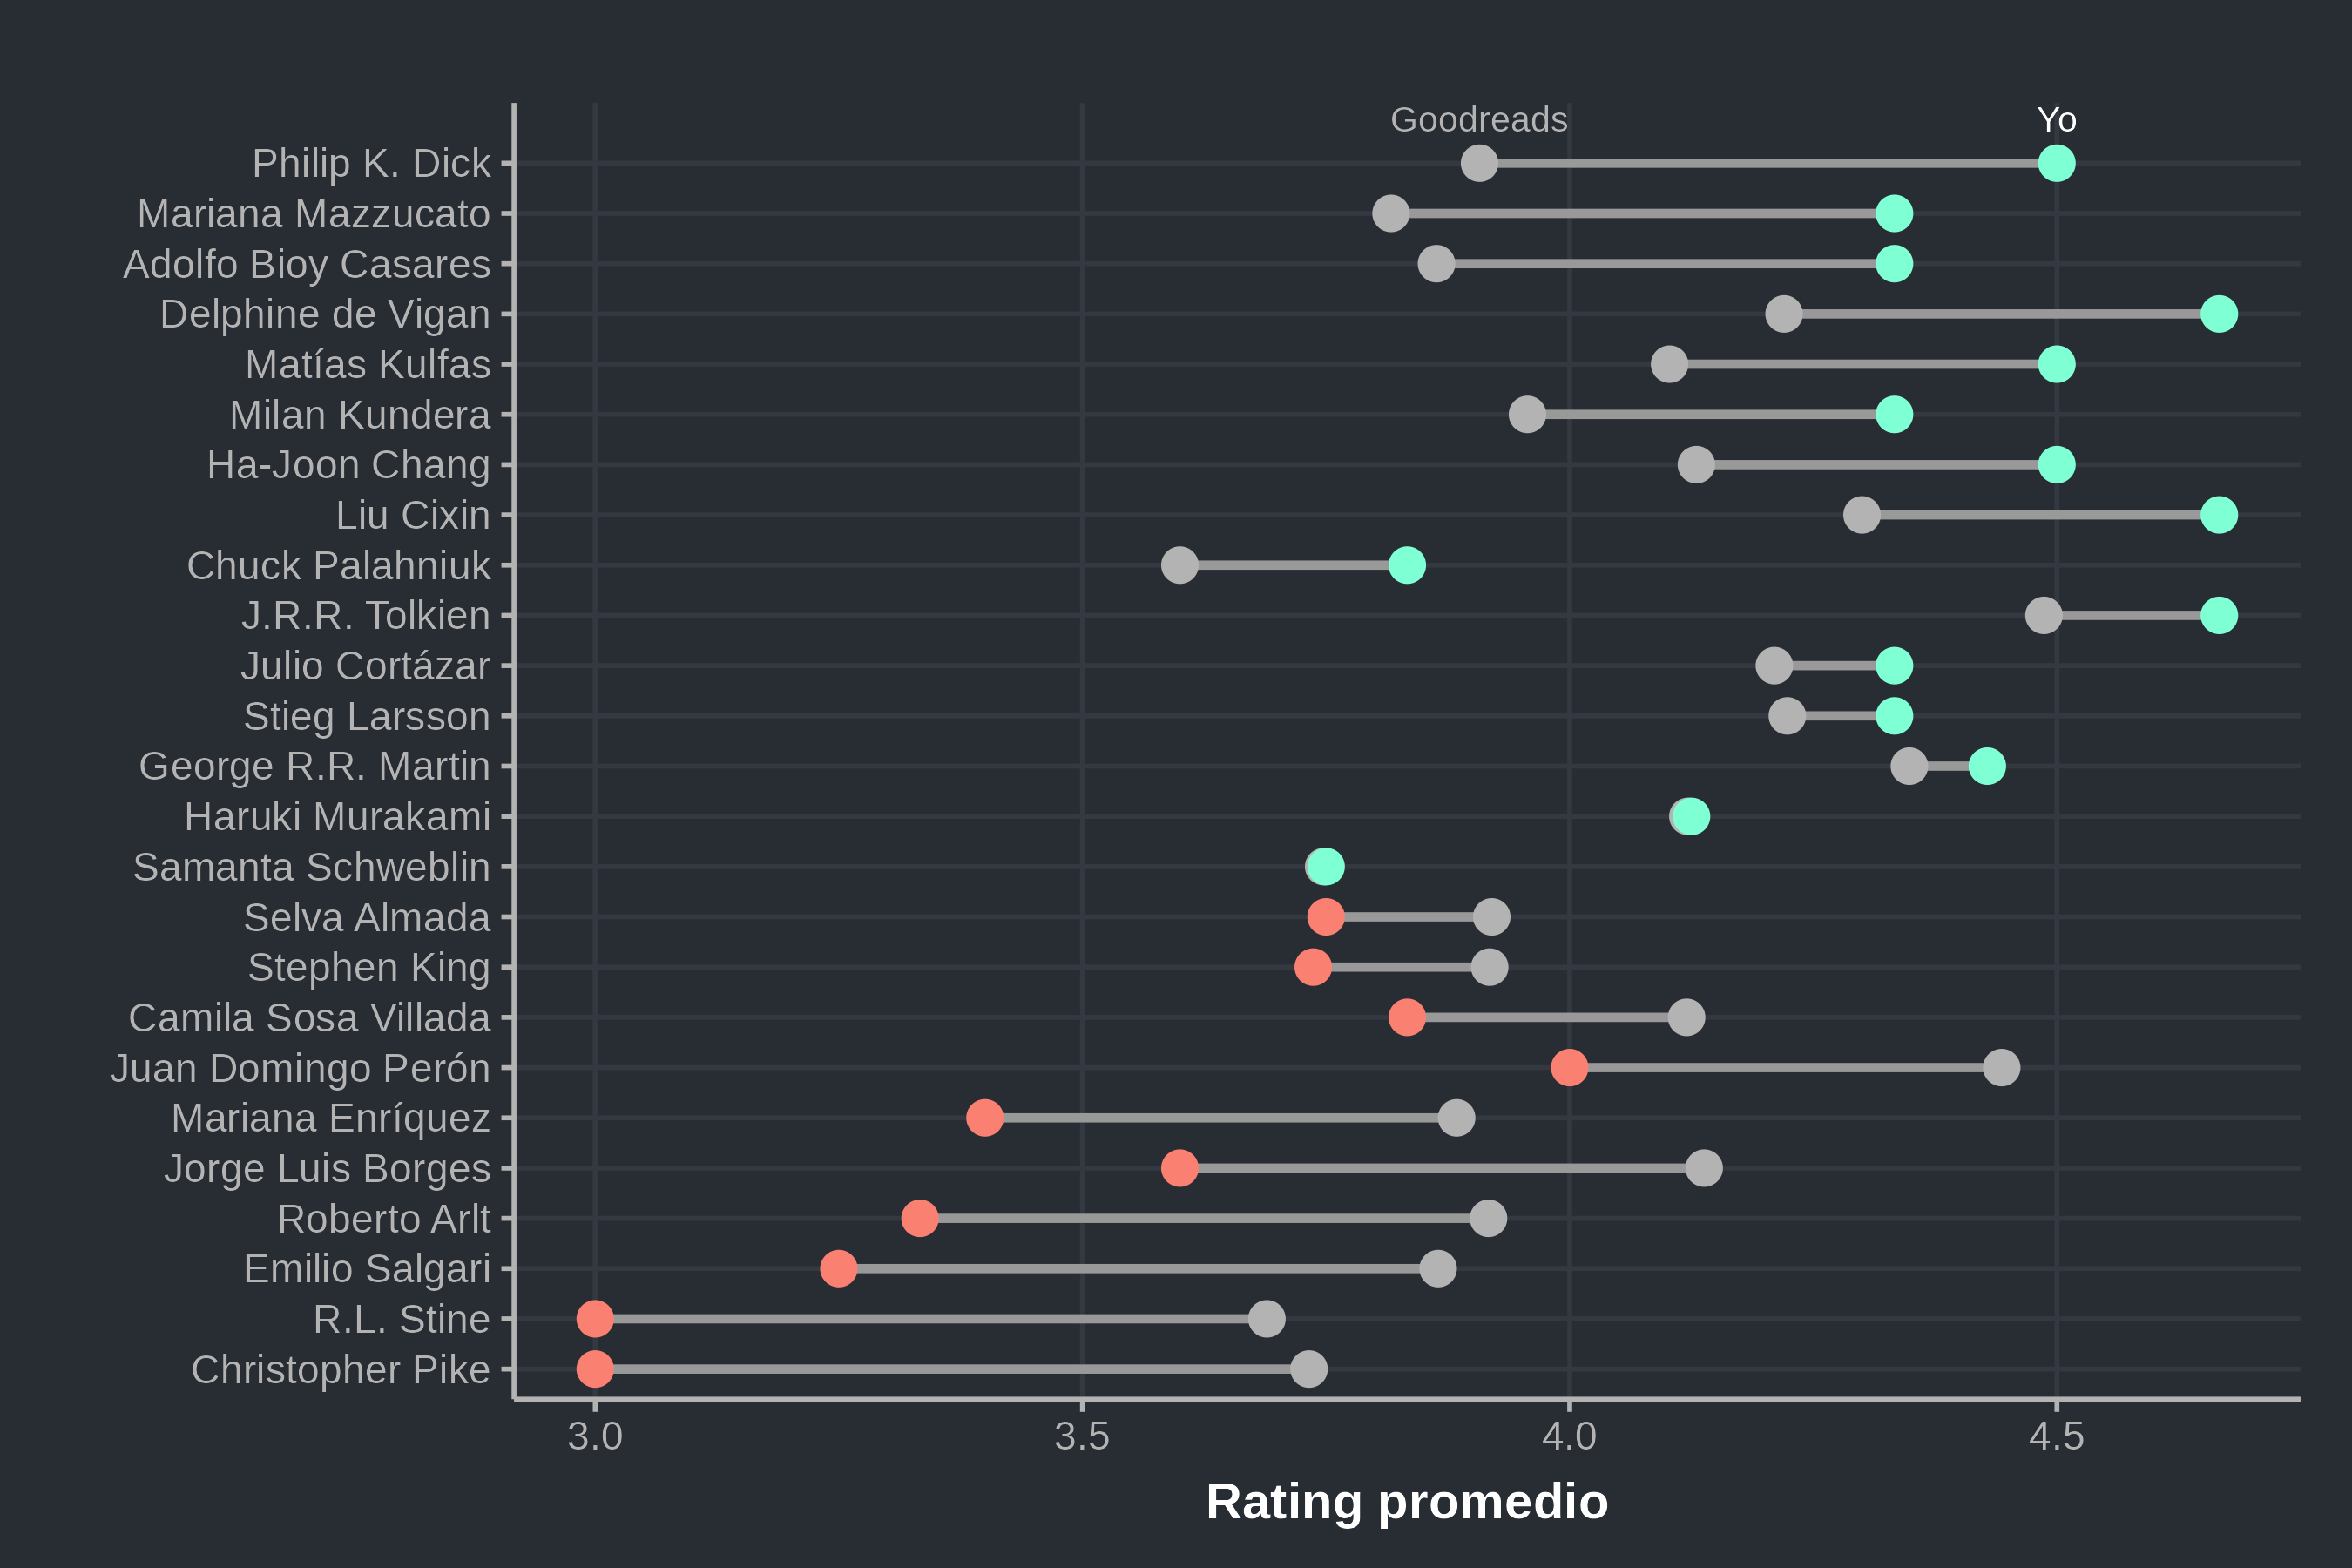
Arriba aparecen Philip K. Dick y Mariana Mazzucato. Abajo, R. L. Stine y Christopher Pike, a los que puntué con 3 contra más de 3,5 del promedio.
Para cerrar
Si tienen cuenta en Goodreads, pueden exportar su biblioteca y probar con sus propios datos. Lo único que van a tener que agregar a mano son las columnas de país, género, idioma y tipo. Y si quieren ver qué estoy leyendo ahora, me pueden seguir en Goodreads.